Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Boutique
Accédez à vos fichiers et gérez votre compte de stockage.
Calculer
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Envoyer directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Boutique
Sauvegardez des photos et des fichiers sur tous vos appareils.
Calculer
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir EnvoyerVous avez déjà un compte ? Connectez-vous
Un comparatif tarifaire clair en Europe pour Qwen3.6-27B
La tarification de l'inférence IA semble simple jusqu'à ce que deux fournisseurs facturent le même modèle de manières totalement différentes.
Prenons l'exemple de Qwen3.6-27B.
Le point de terminaison Qwen3.6-27B d'OVHcloud facture 0,40 € par million de jetons en entrée et 2,70 € par million de jetons en sortie.
L'API d'inférence Hivenet adopte une approche différente pour les charges de travail en production. Les points de terminaison dédiés sont tarifés par réplique et facturés à la seconde. Un point de terminaison de taille moyenne pour des charges de travail de type Qwen commence actuellement à 2,10 € par heure.
L'un des tarifs augmente avec chaque jeton.
L'autre achète une capacité de modèle dédiée pour toute la durée de votre exécution.
Cela signifie qu'il n'y a pas de réponse simple à la question « lequel est le moins cher ? » sans d'abord répondre à une autre question :
Quel volume d'inférence exécutez-vous réellement ?
À faible volume, le paiement au jeton est judicieux
Prenons une charge de travail qui génère 500 millions de jetons par mois.
Pour rendre la comparaison concrète, supposons trois jetons en entrée pour chaque jeton en sortie. Cela donne aux tarifs publiés de Qwen3.6-27B chez OVHcloud un coût moyen de 0,975 € par million de jetons.
Pour 500 millions de jetons, cela revient à :
487,50 € par mois.
Un point de terminaison Hivenet medium fonctionnant en continu au prix de départ actuel de 2,10 €/heure coûterait environ :
1 533 € pour un mois de 730 heures.
À ce niveau d'utilisation, la conclusion est simple.
Si seul le coût par jeton vous importe et que votre trafic est adapté à une API partagée, il est difficile de justifier une capacité dédiée uniquement sur la base du prix.
C'est précisément là que la tarification au jeton excelle.
Vous consommez ce dont vous avez besoin. Vos coûts suivent votre usage. Pour le développement, les projets pilotes, les applications intermittentes et les services à faible volume, cette simplicité est précieuse.
C'est alors que les courbes commencent à diverger
Augmentons maintenant le volume.
À 1 milliard de jetons par mois, la même charge de travail OVHcloud coûte environ 975 €.
À 1,5 milliard, elle atteint environ 1 462,50 €.
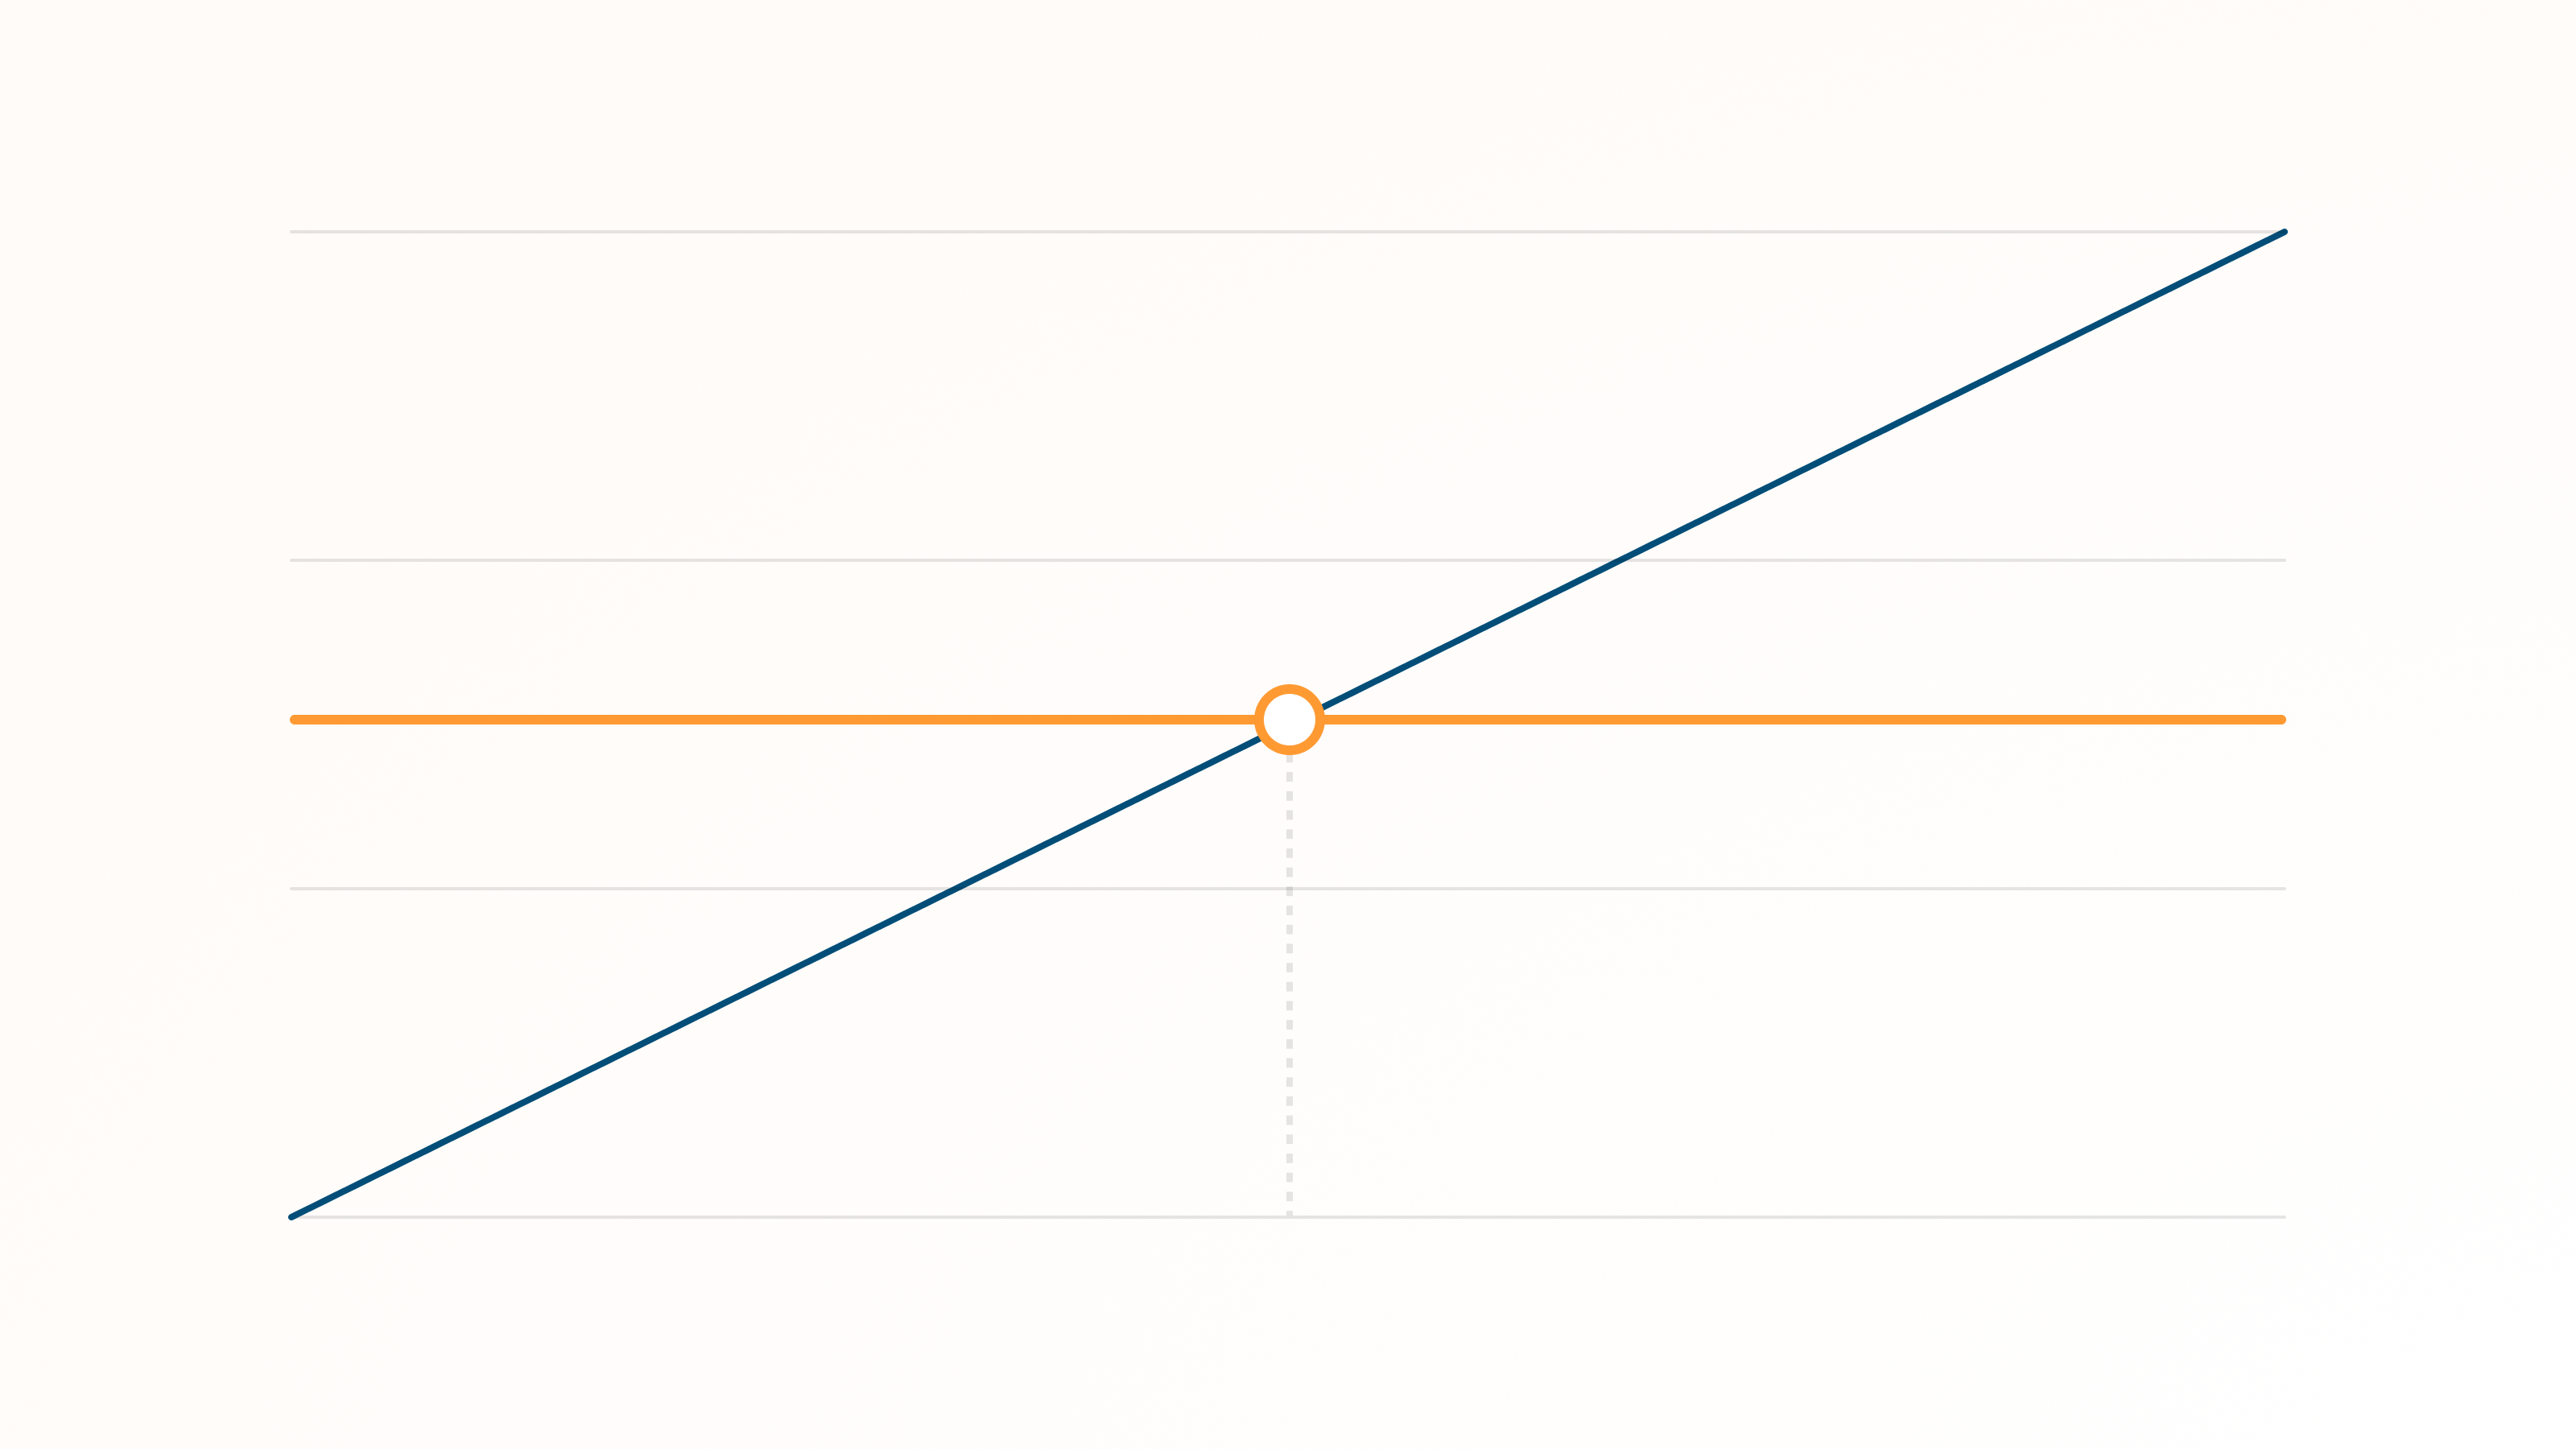
À environ 1,57 milliard de jetons, on atteint approximativement le coût mensuel d'un point de terminaison Hivenet moyen fonctionnant en continu au tarif de base publié.
Au-delà de ce seuil, l'économie s'inverse, en supposant qu'une réplique dédiée puisse supporter la charge de travail.
À 2 milliards de jetons, l'exemple d'OVHcloud atteint 1 950 €.
À 3 milliards, il atteint 2 925 €.
La réplique Hivenet ne devient pas plus coûteuse simplement parce qu'elle traite davantage de jetons. Les points de terminaison dédiés de Hivenet utilisent une tarification par réplique plutôt qu'un compteur de jetons.
C'est là toute la différence commerciale entre les deux modèles.
La tarification au jeton transfère le problème de la capacité inutilisée à un tiers. La tarification dédiée vous permet d'exploiter la capacité pour laquelle vous payez déjà.
Ce point de bascule est utile, mais il ne constitue pas une garantie de capacité
Une condition importante est associée à ce chiffre de 1,57 milliard de jetons.
Une réplique Hivenet doit être en mesure de gérer la charge de travail.
Le volume de jetons ne suffit pas à vous l'indiquer.
Trois milliards de jetons répartis uniformément sur un mois posent un problème de service différent de trois milliards de jetons arrivant par pics importants durant les heures de bureau. Les invites longues se comportent différemment des invites courtes. Les charges de travail générant beaucoup de contenu imposent des exigences différentes au modèle. Les objectifs de latence et la concurrence comptent également.
C'est pourquoi il s'agit d'un seuil de rentabilité, et non d'une garantie qu'un point de terminaison peut gérer n'importe quelle charge de travail en dessous ou au-dessus d'un nombre de jetons spécifique.
La tarification dédiée de Hivenet dépend de la famille de modèles, du niveau du point de terminaison, de la configuration des réplicas et du mode de déploiement. Sa tarification publique actuelle affiche des points de terminaison intermédiaires pour les charges de travail de type Qwen à partir de 2,10 €/heure, facturés à la seconde.
La question commerciale pertinente n'est donc pas :
« Combien de jetons utilisez-vous ? »
C'est :
« Combien de jetons utilisez-vous, quand les utilisez-vous et quelles performances attendez-vous pendant leur traitement ? »
Cela suffit à transformer une facture d'API générique en une décision d'infrastructure.
Les charges de travail à forte production atteignent le seuil de rentabilité plus rapidement
Les jetons d'entrée et de sortie n'ont pas le même coût sur le point de terminaison Qwen3.6-27B d'OVHcloud.
Son prix public actuel est de 0,40 € par million de jetons d'entrée et de 2,70 € par million de jetons de sortie.
C'est pourquoi la répartition des jetons est importante.
Notre exemple utilise un ratio entrée/sortie de 3:1. Modifiez la charge de travail et l'économie changera en conséquence.
Une application qui lit de longs documents et produit des réponses structurées courtes penchera davantage vers le coût plus avantageux des jetons d'entrée.
Une application conversationnelle ou axée sur la génération, produisant des réponses substantielles, consommera proportionnellement plus de jetons de sortie et atteindra un coût mixte plus élevé plus rapidement.
La capacité dédiée ne facture pas ces deux types de jetons séparément.
Cela peut rendre son modèle économique particulièrement intéressant pour les charges de travail où la génération de sortie représente une part importante de la facture.
Vous achetez également un modèle opérationnel différent
Le prix n'est qu'une des différences entre ces deux offres.
AI Endpoints d'OVHcloud offre aux développeurs un accès géré à Qwen3.6-27B via une API, avec une facturation basée sur la consommation de jetons. Sa page de modèle actuelle indique une fenêtre de contexte de 262 000 jetons, la prise en charge multimodale, l'appel de fonctions et le streaming.
Le produit d'inférence géré de Hivenet offre au client une capacité de point de terminaison dédiée. Hivenet exploite le routeur, la passerelle, l'environnement d'exécution, l'observabilité, la couche de réplication et le point de terminaison tout en exposant une API compatible avec OpenAI. Les points de terminaison peuvent être déployés via des zones géographiques incluant la France, les Émirats arabes unis et les États-Unis.
La décision d'achat ne se résume donc pas simplement à :
0,975 €/M contre 2,10 €/heure.
Il s'agit également de :
consommation partagée contre capacité dédiée.
Cette distinction devient plus importante à mesure qu'une charge de travail IA passe de l'expérimentation à une solution sur laquelle l'entreprise s'appuie au quotidien.
L'efficacité est ce qui rend la capacité dédiée intéressante
L'infrastructure dédiée présente une faiblesse évidente.
Si le modèle reste inactif, vous continuez à payer pour la réplique tant qu'elle est en cours d'exécution.
La rentabilité s'améliore lorsque la capacité est utilisée.
C'est là que le travail de Hivenet sur l'efficacité de l'inférence prend tout son sens.
Notre configuration de service pour Qwen3.6-27B utilise la moitié du matériel requis par la pleine précision, tout en conservant les capacités entre 95,5 % et 100 % sur l'ensemble des benchmarks de précision rapportés.
Nous abordons l'aspect matériel dans pourquoi la moitié des changements matériels modifie l'économie de l'inférence IA, et l'aspect qualité dans notre comparatif des benchmarks NVFP4 du Qwen3.6-27B.
L'argument commercial est simple.
Il devient beaucoup plus facile de proposer des tarifs compétitifs sur une capacité dédiée lorsque le modèle lui-même peut être exploité efficacement.
Et comme différents fournisseurs de Qwen3.6-27B font des choix d'exploitation différents, le nom du modèle ne suffit pas à indiquer l'efficacité de l'infrastructure sous-jacente.
L'Europe nous offre une comparaison particulièrement claire
Les comparaisons entre fournisseurs cloud sont souvent faussées par les devises.
Un fournisseur facture en dollars, un autre en euros, et une légère fluctuation des taux de change suffit à modifier l'avantage tarifaire d'une semaine à l'autre.
Ici, nous pouvons éviter cela.
OVHcloud publie ses tarifs en euros pour le Qwen3.6-27B sur son site européen : 0,40 €/M en entrée et 2,70 €/M en sortie.
Hivenet publie également ses tarifs d'inférence gérée en euros, avec des endpoints dédiés de taille moyenne à partir de 2,10 €/heure.
Aucune conversion de devise n'est nécessaire.
La seule chose à ajuster est l'unité.
Une fois les deux modèles appliqués à une charge de travail mensuelle réelle, le compromis devient beaucoup plus évident.
Le bon modèle tarifaire suit la charge de travail
Rien ne justifie d'imposer le même modèle de facturation à toutes les applications d'IA.
Si votre charge de travail est faible, imprévisible ou très intermittente, une facturation à la consommation (au jeton) peut être exactement ce qu'il vous faut.
Si votre modèle tourne en continu et que votre volume de production ne cesse de croître, payer pour chaque jeton supplémentaire peut finir par devenir une manière coûteuse d'acheter de l'infrastructure.
C'est à ce moment-là qu'il convient d'envisager une capacité dédiée.
Le seuil ne sera pas le même pour chaque équipe. Il varie en fonction de la répartition des jetons, de la concurrence, de la latence, du temps d'exécution, de la configuration du modèle et du nombre de réplicas requis.
Mais le principe reste le même :
En cas de faible utilisation, payez à la consommation. En cas d'utilisation soutenue, commencez à vous interroger sur le coût de la capacité sous-jacente.
Pour Qwen3.6-27B en Europe, la tarification publique actuelle rend cette question très concrète.
Avec un ratio d'entrée/sortie de 3:1, la facturation au jeton d'OVHcloud revient à 0,975 € par million de jetons.
L'offre de point de terminaison dédié intermédiaire de Hivenet commence à 2,10 € de l'heure.
Pour un point de terminaison fonctionnant en continu, ces deux courbes économiques se croisent à environ 1,57 milliard de jetons par mois, si un seul réplica Hivenet peut supporter la charge de travail.
En dessous de ce seuil, la facturation au jeton est plus avantageuse dans cette comparaison simplifiée.
Au-delà, la capacité dédiée change la donne.
Et dès qu'une facture d'IA en production atteint cette échelle, cela vaut la peine d'en discuter.
Explorer l'API d'inférence Hivenet ou Contactez notre équipe au sujet de votre volume de jetons, de vos modèles de trafic, de vos objectifs de latence, de votre région et de vos besoins en modèles.
Your next workload belongs on Hivenet.
Pick one AI, compute, or storage workload and see the difference for yourself. Spin it up in minutes, or let our team map your fastest path to production.