Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Boutique
Accédez à vos fichiers et gérez votre compte de stockage.
Calculer
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Envoyer directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Boutique
Sauvegardez des photos et des fichiers sur tous vos appareils.
Calculer
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir EnvoyerVous avez déjà un compte ? Connectez-vous
Le coût réel de l'inférence 4 bits en termes de qualité de modèle
L'inférence 4 bits s'accompagne d'une promesse séduisante : faire fonctionner un modèle performant avec beaucoup moins de mémoire et de matériel.
La question évidente est de savoir ce que vous y perdez.
Cette question est cruciale, car le modèle le moins coûteux à exploiter reste onéreux s'il ne remplit plus la mission pour laquelle vous l'avez choisi. Une empreinte matérielle réduite n'a de valeur que si les capacités du modèle restent dans une plage acceptable pour votre charge de travail.
Plutôt que de qualifier notre quantification Qwen3.6-27B de « quasi sans perte », nous l'avons mesurée.
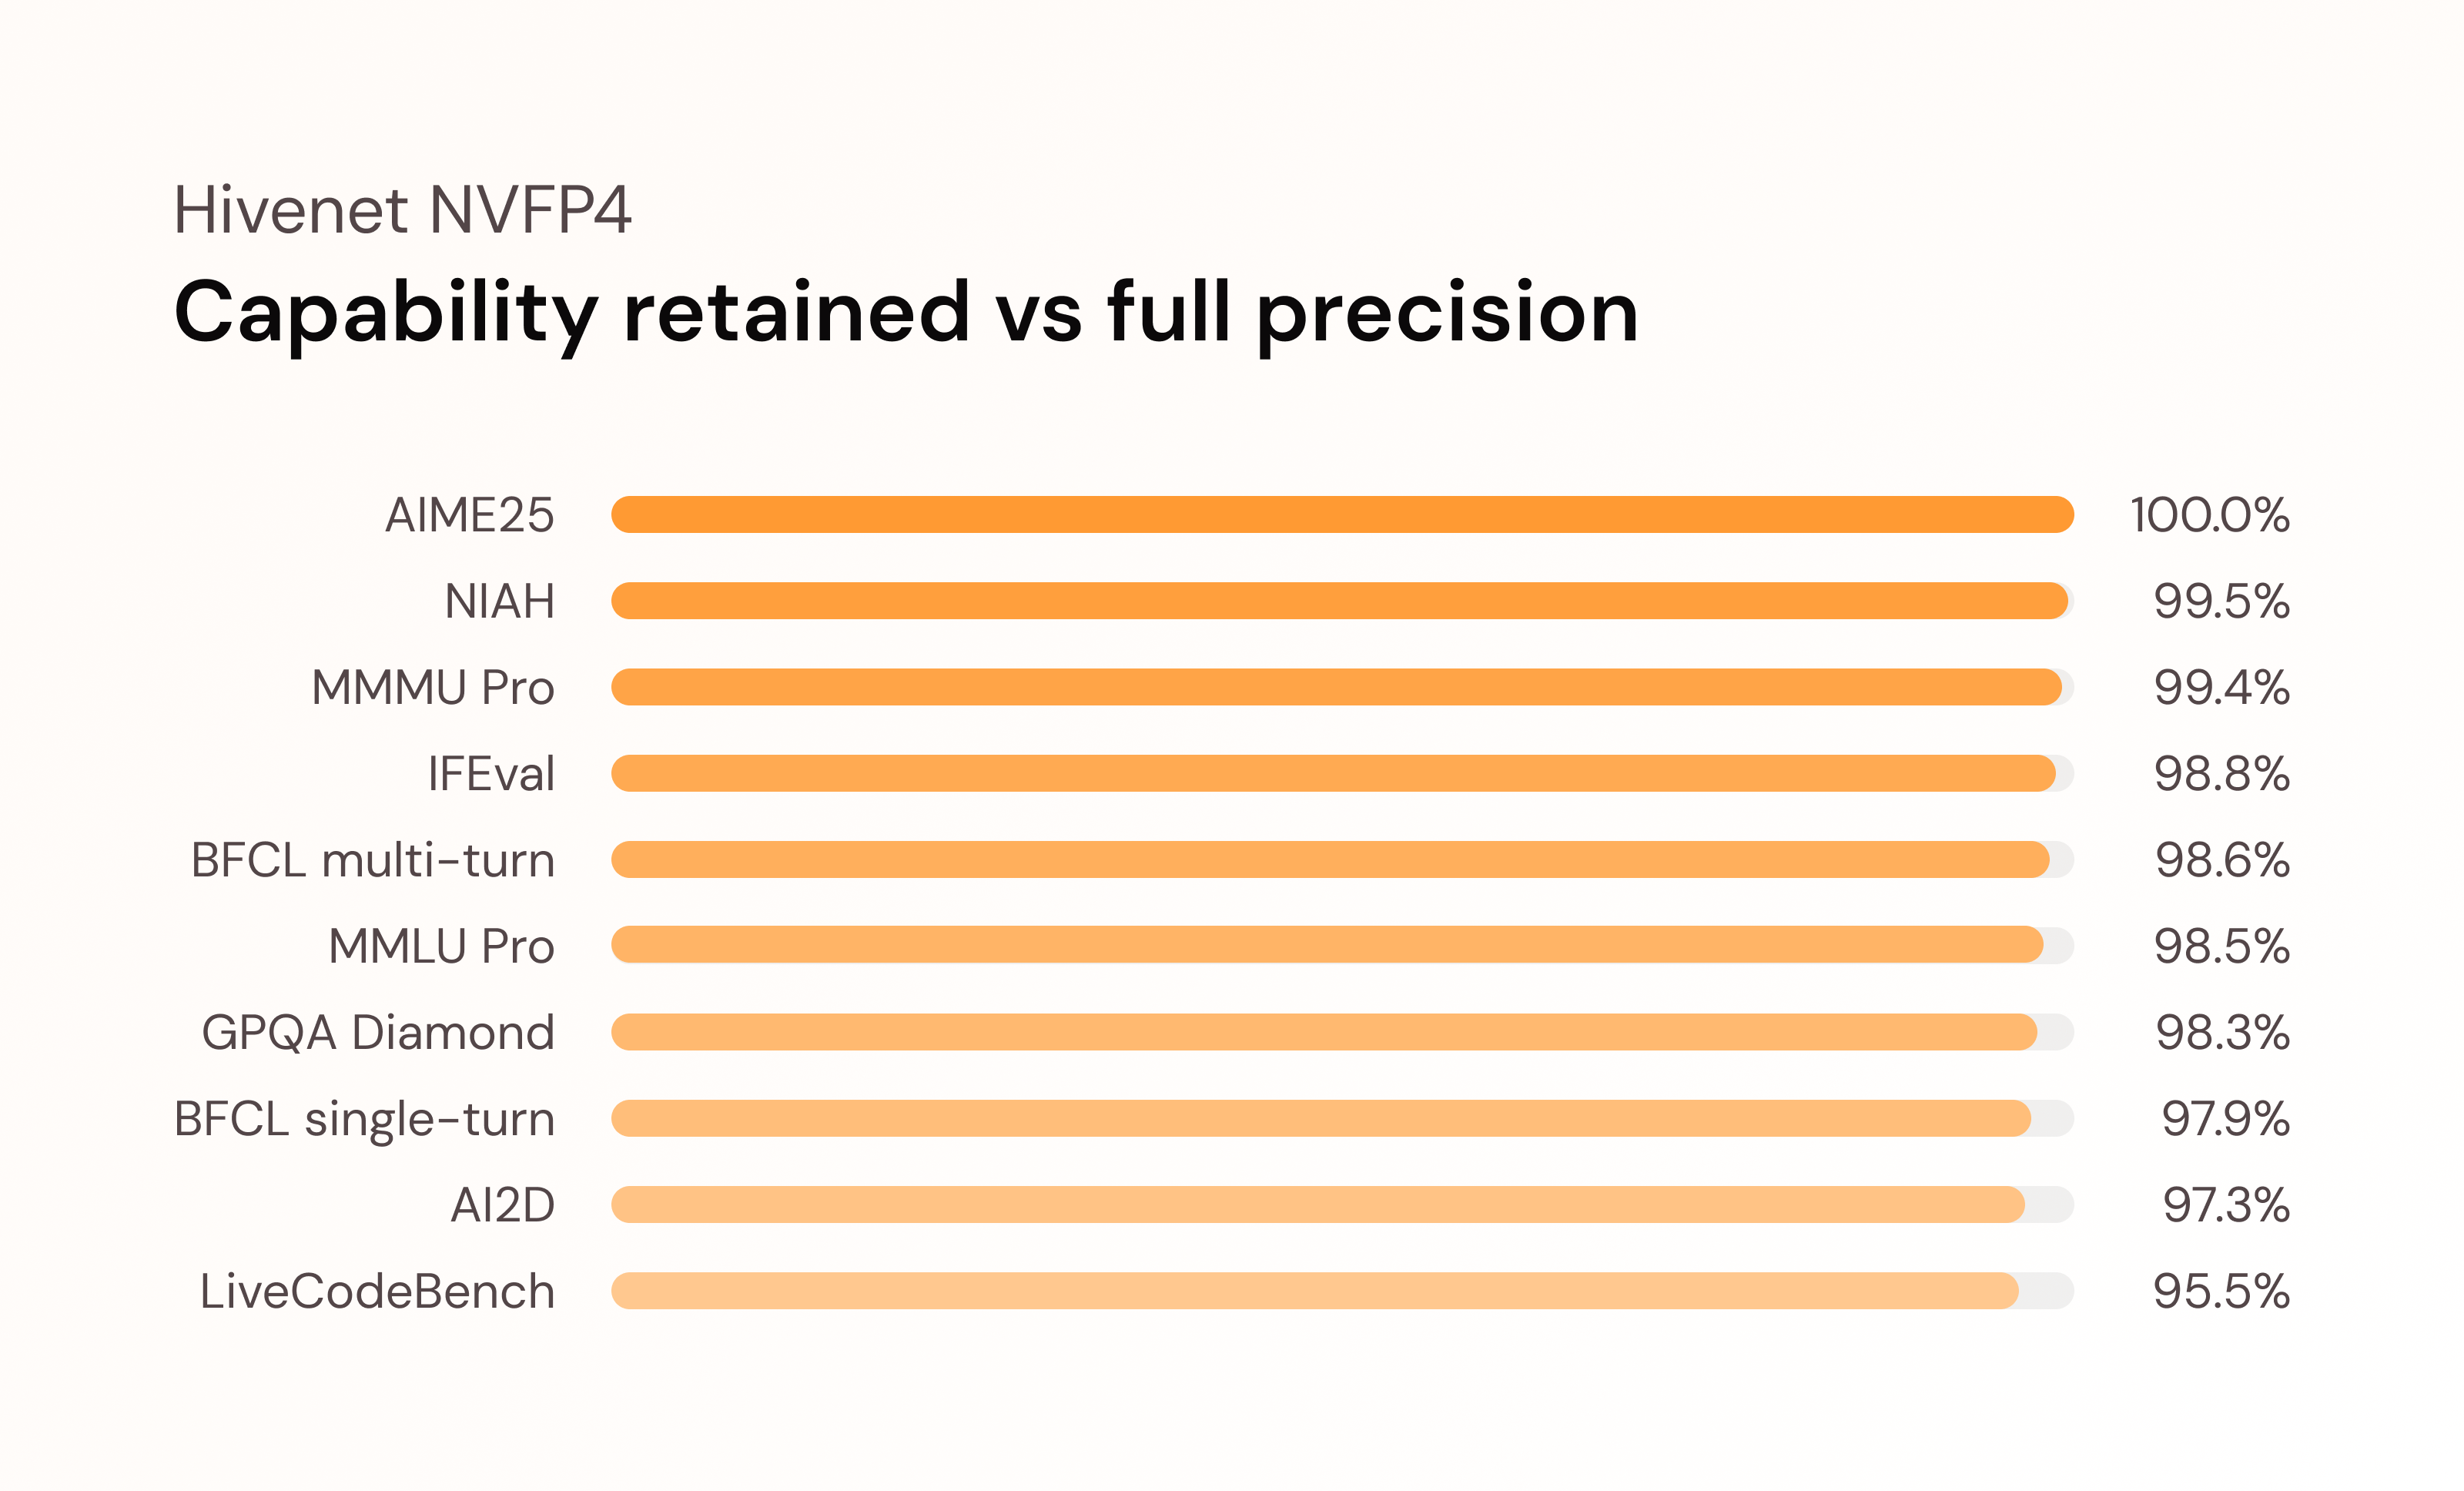
Sur dix benchmarks de précision, la configuration NVFP4 à précision mixte de Hivenet a conservé entre 95,5 % et 100 % des capacités du modèle en pleine précision.
Le résultat le plus faible concerne la génération de code. Le plus élevé ne montre aucune perte mesurable.
Ce sont les chiffres que les acheteurs devraient, selon nous, prendre en compte.
Le 4 bits économise le matériel. Voici le bilan en termes de qualité.
La quantification réduit la précision utilisée pour représenter certaines parties d'un modèle. Moins de bits signifie généralement moins de mémoire, ce qui peut faire une différence substantielle sur l'infrastructure requise pour l'inférence.
Avec Qwen3.6-27B, la configuration NVFP4 de Hivenet nécessite la moitié du matériel requis pour la pleine précision.
Mais le terme « 4 bits » seul en dit étonnamment peu sur le modèle que vous finissez par exécuter.
La manière dont le modèle est quantifié est déterminante. Les différentes couches réagissent différemment à une précision réduite, et traiter chaque partie d'un modèle de la même manière peut sacrifier des capacités qui méritaient d'être préservées.
Notre configuration utilise une précision mixte. Une analyse de sensibilité détermine où le format NVFP4 4 bits peut être appliqué et où les parties du modèle les plus sensibles à la précision doivent rester protégées par une précision supérieure.
Le NVFP4 est un format à virgule flottante 4 bits pris en charge par le matériel NVIDIA BlackwellPour une explication technique plus approfondie, notre guide sur le NVFP4 sur Blackwell détaille le format et l'importance de la précision mixte.
Pour un acheteur, le résultat est plus facile à interpréter :
deux fois moins de matériel, avec un coût de qualité mesuré plutôt qu'indéterminé.
Le résultat le plus faible est de 95,5 %, et non « environ 99 % ».
Il est tentant de présenter ces résultats de manière marketing.
Faire une moyenne de tout, arrondir généreusement et affirmer que le 4 bits conserve environ 99 % de la qualité du modèle.
Nous ne pensons pas que cela soit utile.
L'écart entre les benchmarks est important car les charges de travail diffèrent.
Sur AIME25, le résultat mesuré est resté identique à celui de la pleine précision. NIAH et MMMU Pro ont conservé plus de 99 %. MMLU Pro et GPQA Diamond ont dépassé les 98 %. AI2D a conservé 97,3 %.
Vient ensuite LiveCodeBench.
Sur ce benchmark de génération de code, la capacité conservée est tombée à 95,5 %, soit le résultat le plus faible de la série.
Si votre application dépend fortement de la génération de code complexe, ce chiffre mérite plus d'attention qu'une moyenne calculée sur des tests sans rapport.
Si vous développez un système RAG, un flux de travail documentaire, un agent, une application multimodale ou tout autre service de production, une autre partie de l'éventail des benchmarks pourrait s'avérer plus pertinente.
C'est pourquoi il n'existe pas de réponse unique et honnête à la question : « Quelle perte de qualité entraîne le 4 bits ? »
Pour cette configuration, la réponse est : entre aucune perte mesurée et une perte de capacité relative de 4,5 % sur l'ensemble des benchmarks de précision que nous avons effectués.
Vous pouvez voir où.
Ce que couvre le benchmark
Nous avons testé la configuration NVFP4 par rapport à la pleine précision sur la même infrastructure en utilisant les mêmes germes aléatoires.
La suite couvre plusieurs types de comportements du modèle plutôt que de se reposer sur un seul benchmark phare :
DomaineExemples dans le benchmarkRaisonnement et connaissancesAIME25, MMLU Pro, GPQA DiamondRécupération en contexte longNIAHSuivi d'instructionsIFEvalUtilisation d'outilsBFCL simple et multi-tourCompréhension multimodaleMMMU Pro, AI2DCode générationLiveCodeBench
Cette étendue est importante car la quantification n'affecte pas nécessairement toutes les capacités de la même manière.
Une configuration qui semble excellente pour les connaissances générales peut perdre davantage de terrain en programmation. Un modèle qui se maintient sur le raisonnement court peut se comporter différemment avec des outils ou un contexte long.
Les benchmarks ne peuvent pas vous dire si un modèle passera vos tests d'acceptation en production. Ils peuvent vous indiquer où regarder.
Pour les équipes qui comparent des modèles ou des configurations de service, notre guide sur la lecture des benchmarks d'inférence LLM explique pourquoi la qualité du modèle, la latence, le débit, la concurrence et le coût doivent être évalués ensemble.
C'est là que la précision mixte prend tout son sens
Il existe deux manières simplistes d'aborder l'optimisation de l'inférence.
Tout garder en haute précision et accepter le coût matériel. Ou réduire la précision partout et espérer que le modèle survive à la compression.
La précision mixte vous offre une autre option.
Au lieu de demander si Qwen3.6-27B doit être en « pleine précision » ou en « 4 bits », la question pertinente est de savoir quelles parties du modèle ont réellement besoin de cette précision supplémentaire.
Le processus de quantification de Hivenet utilise la sensibilité des couches pour prendre cette décision.
Cela permet de réaliser une économie plus importante de 4 bits là où le modèle le tolère, tout en protégeant les parties plus sensibles à cette réduction.
C'est l'une des raisons pour lesquelles l'expression « modèle 4 bits » ne doit pas être considérée comme une spécification complète.
Deux fournisseurs peuvent proposer le même modèle de base Qwen3.6-27B, décrire tous deux leur version comme quantifiée, et pourtant faire fonctionner des configurations sous-jacentes sensiblement différentes.
Le choix de la précision fait partie intégrante du produit.
Tout comme le fait de savoir ce que ce choix implique.
Le véritable compromis est celui de la qualité par rapport à l'efficacité, et non de la qualité pour elle-même.
Un résultat de 95,5 % serait difficile à évaluer isolément.
L'autre volet de la comparaison est ce qu'Hivenet obtient en retour.
La configuration NVFP4 nécessite la moitié du matériel requis pour une précision totale pour ce modèle.
Cela modifie l'économie de son déploiement. Moins de ressources sont nécessaires pour maintenir le modèle disponible avant même que le volume de trafic, le traitement par lots, le débit et l'utilisation n'entrent en ligne de compte.
Accepterions-nous une perte de 4,5 % sur un benchmark sans aucun avantage pratique ? Non.
Évaluerions-nous ce compromis en échange d'une réduction de moitié des besoins matériels sous-jacents ? Absolument.
Et la réponse peut toujours être non pour une charge de travail spécifique.
Si une application de codage a besoin de chaque point que LiveCodeBench peut préserver, une précision plus élevée peut être le meilleur choix. Si le seuil d'acceptation en production est confortablement inférieur au résultat NVFP4 mesuré, payer pour deux fois plus de matériel pourrait offrir des capacités dont l'application n'a pas besoin.
La bonne décision consiste à mettre les deux chiffres en parallèle.
Qu'est-ce que l'optimisation permet d'économiser, et quel en est le coût ?
Pour Qwen3.6-27B sur Hivenet, les deux aspects sont mesurables.
Vous n'êtes pas obligé de nous croire sur parole concernant la configuration
Un autre aspect de ce travail est essentiel pour les équipes évaluant l'IA en production : le modèle est inspectable.
Le modèle HivenetQuant Qwen3.6-27B NVFP4 publie les poids et la recette de quantification plutôt que de réduire l'implémentation à une simple étiquette commerciale.
La version de service publique est une reconstruction fidèle issue du même plan de recherche de quantification que celui utilisé pour le point de contrôle de référence, plutôt qu'une copie conforme octet par octet de ce dernier. Nous faisons cette distinction explicitement car la reproductibilité doit décrire ce qui peut réellement être reproduit.
Vous pouvez inspecter la manière dont le modèle a été quantifié, voir quels choix de précision ont été effectués et évaluer le résultat par rapport à votre propre charge de travail.
C'est particulièrement utile avec les modèles à poids ouverts. L'accès au modèle offre aux équipes une opportunité que les API propriétaires proposent rarement : tester les compromis exacts de service plutôt que d'accepter le résumé qu'en fait un fournisseur.
Si vous préférez déployer le modèle vous-même, notre guide sur l'exécution de Qwen3.6-27B avec vLLM couvre l'approche auto-hébergée.
Un benchmark doit vous aider à décider, pas prendre la décision à votre place
Il n'existe pas de seuil universel à partir duquel la quantification devient « suffisante ».
Un système de support client, un agent de codage, un extracteur de documents, un assistant de recherche et un flux de travail multimodal n'accordent pas la même importance aux mêmes capacités du modèle.
C'est pourquoi le chiffre de 95,5 % est utile.
Il indique le bas de la plage mesurée au lieu de le masquer. Vous pouvez ensuite décider si ce compromis s'inscrit dans le budget de qualité de votre application.
Pour de nombreuses charges de travail en production, utiliser deux fois moins de matériel tout en conservant au moins 95,5 % de la capacité de base sur cette suite de tests constitue un point de départ convaincant.
Pour certains, cela ne suffira pas.
L'une ou l'autre réponse vaut mieux que de choisir une configuration de service sans connaître son coût en termes d'efficacité.
L'approche de Hivenet consiste à rendre ce compromis visible, puis à laisser la charge de travail décider.
Inspectez le modèle et les poids HivenetQuant, ou discutez avec notre équipe des objectifs de qualité, de débit, de région et de coût que votre charge de travail en production doit atteindre.
Your next workload belongs on Hivenet.
Pick one AI, compute, or storage workload and see the difference for yourself. Spin it up in minutes, or let our team map your fastest path to production.