Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Boutique
Accédez à vos fichiers et gérez votre compte de stockage.
Calculer
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Envoyer directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Boutique
Sauvegardez des photos et des fichiers sur tous vos appareils.
Calculer
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir EnvoyerVous avez déjà un compte ? Connectez-vous
Les détails d'inférence du modèle Qwen3.6-27B que la plupart des fournisseurs ne montrent toujours pas
Vous pouvez acheter un accès à Qwen3.6-27B auprès de plusieurs fournisseurs d'inférence.
Cela ne signifie pas pour autant que vous achetez la même chose.
Le nom du modèle indique quel modèle de base se trouve derrière l'API. Il ne précise pas nécessairement la précision utilisée par le fournisseur, les optimisations appliquées, la taille du contexte disponible, ni si ces modifications ont altéré la qualité du modèle.
Pour un acheteur en environnement de production, ces détails sont cruciaux.
Ils influencent le matériel nécessaire pour exécuter le modèle, la rentabilité de son déploiement, les performances attendues et, potentiellement, les réponses générées par le modèle.
Pourtant, les pages des fournisseurs varient considérablement quant à la transparence sur cette couche de service.
Hivenet adopte une position simple : si une optimisation est suffisamment importante pour améliorer la rentabilité du modèle, son coût en termes de qualité mérite d'être mesuré.
Un même modèle de base peut devenir un produit d'inférence différent
Qwen3.6-27B est un modèle à poids ouverts de 27 milliards de paramètres. Cela offre aux fournisseurs d'inférence une liberté de déploiement bien plus grande que celle permise par une API fermée.
Cette flexibilité est utile.
Un fournisseur peut choisir le matériel, le logiciel de service, la précision numérique, les limites de contexte, la gestion des lots, la configuration du cache et d'autres optimisations autour d'un même modèle de base.
Ces choix font partie intégrante de la concurrence entre les fournisseurs.
C'est aussi pourquoi comparer uniquement les noms des modèles ne suffit pas.
Regardez les offres actuelles de Qwen3.6-27B disponibles sur le marché.
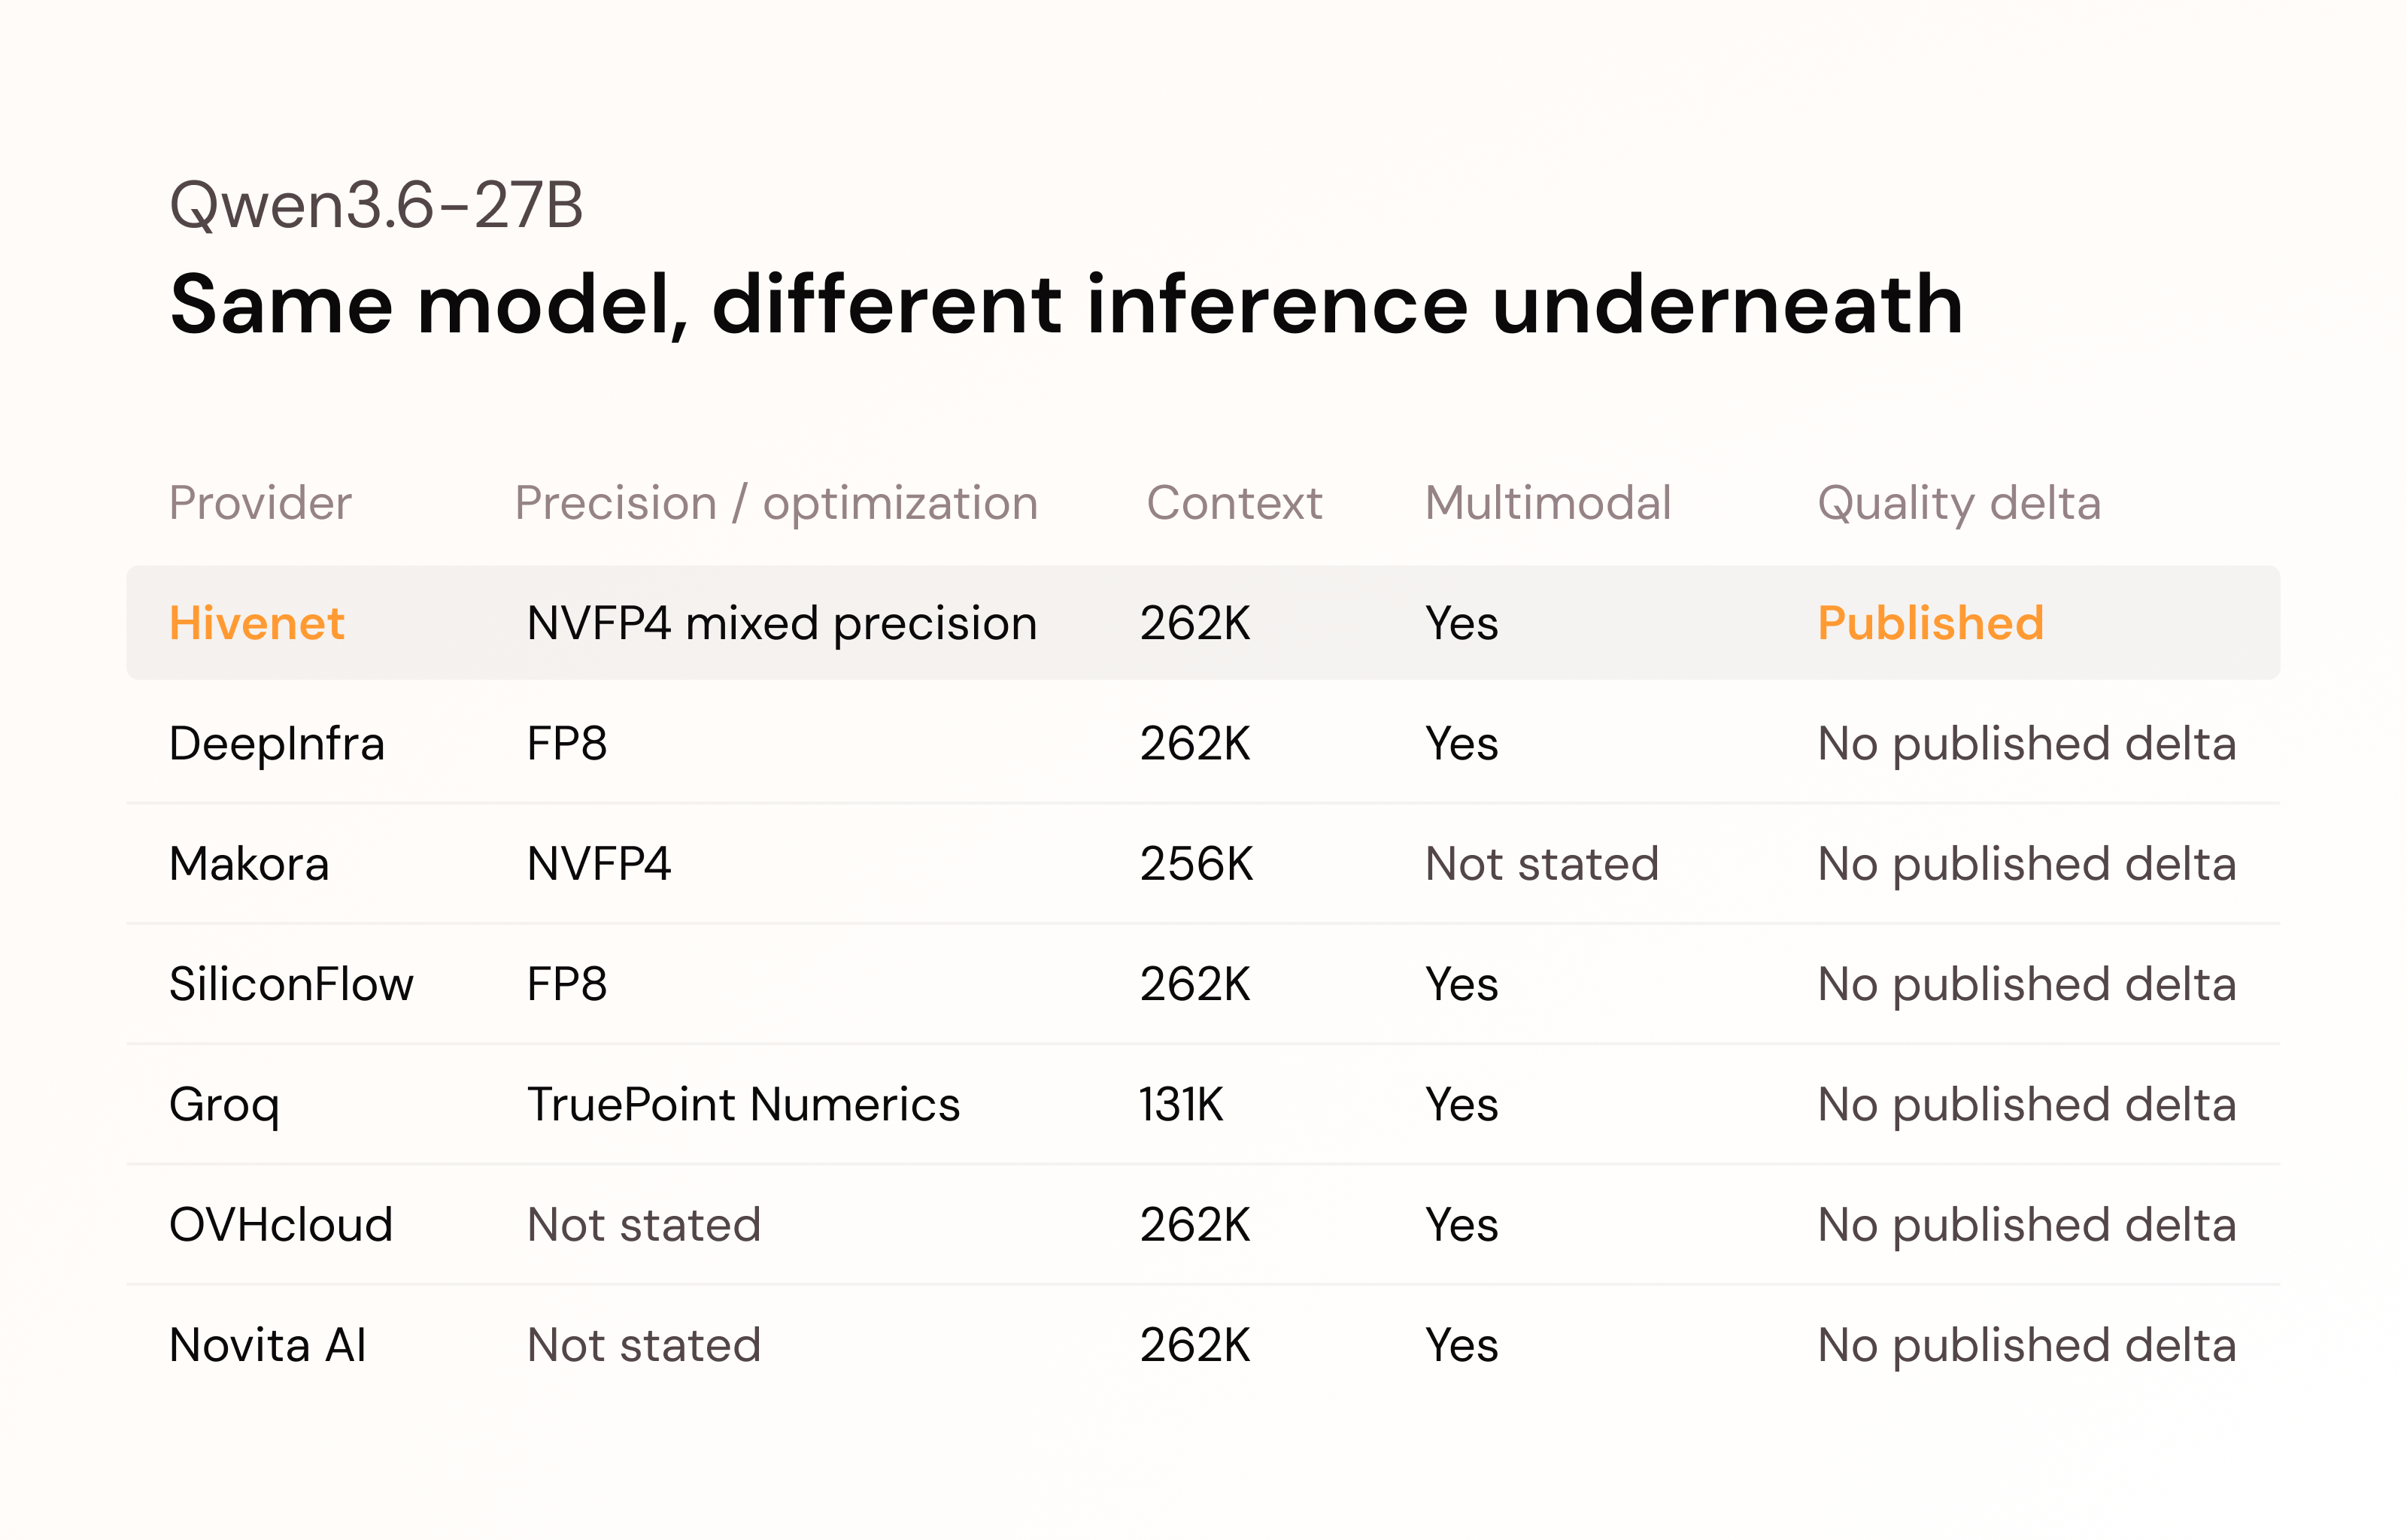
DeepInfra indique qu'il propose le modèle en FP8 avec une fenêtre de contexte de 262 144 jetons.
SiliconFlow mentionne également le FP8 et un contexte de 262K.
Makora nomme explicitement sa version Qwen3.6-27B-NVFP4 et indique un contexte de 256K.
Groq adopte une approche différente en décrivant son système propriétaire TruePoint Numerics plutôt que d'utiliser une étiquette de précision binaire conventionnelle. Son point de terminaison Qwen3.6-27B propose une fenêtre de contexte de 131K.
OVHcloud affiche une fenêtre de contexte de 262K et une prise en charge multimodale, mais ne précise pas la précision de service sur sa page publique dédiée au modèle.
Novita AI indique une fenêtre de contexte de 262 144 jetons ainsi que des entrées texte, image et vidéo, mais ses documents publics sur le Qwen3.6-27B ne mentionnent pas la précision de service.
Toutes ces méthodes peuvent être parfaitement valables pour servir le modèle.
Il ne s'agit pas de la même configuration.
Connaître la précision ne représente que la moitié de la réponse
Les fournisseurs d'inférence évoquent de plus en plus la quantification et la précision numérique, car les avantages sont considérables.
Le FP8 permet de réduire les besoins en mémoire par rapport à une précision supérieure. Les formats 4 bits permettent de les réduire davantage. Les systèmes numériques propriétaires permettent d'effectuer leurs propres arbitrages entre précision et performance.
Cela indique à l'acheteur ce que le fournisseur a modifié.
Cela ne lui dit pas ce que ce changement a produit sur le modèle.
Cette seconde question est la plus importante.
Si une configuration optimisée coûte moins cher à exploiter mais réduit également la précision sur les tâches dont vous dépendez, vous devez connaître les deux facettes de ce compromis avant de pouvoir juger de son efficacité.
C'est là que l'approche de Hivenet se distingue.
Nous utilisons Qwen3.6-27B avec une précision mixte NVFP4 W4A4, les parties du modèle les plus sensibles à la précision étant protégées par un niveau supérieur.
Nous comparons ensuite cette configuration à la précision totale.
Le résultat n'est pas une affirmation générique selon laquelle la quantification est « quasi sans perte ». Il s'agit d'un ensemble d'écarts mesurés sur différents types de tâches.
Sur les dix benchmarks de précision rapportés, la capacité conservée varie de 100 % à 95,5 %.
Le résultat le plus faible est visible.
Tout comme les plus performants.
La transparence transforme « optimisé » en quelque chose que vous pouvez évaluer
« Optimisé » est un mot facile à apposer sur un produit d'inférence.
La partie difficile consiste à montrer ce qui a été optimisé et ce qui a changé en conséquence.
Pour notre configuration Qwen3.6-27B, le compromis est concret.
Le modèle nécessite la moitié du matériel requis pour la précision totale à notre précision de service.
En termes de qualité, le résultat le plus faible conserve 95,5 % des capacités en pleine précision, les autres évaluations se situant entre 97,3 % et 100 %.
Cela donne à l'acheteur deux chiffres exploitables :
Qu'a permis d'économiser l'optimisation ?
La moitié des besoins matériels.
Quel a été le coût de l'optimisation ?
Entre aucune perte mesurable et une perte de capacité relative de 4,5 % sur les tests de précision que nous avons effectués.
Cette réponse ne rendra pas cette configuration adaptée à toutes les charges de travail.
Elle rend toutefois le compromis suffisamment clair pour prendre une décision.
Notre guide sur le NVFP4 détaille le format de précision sous-jacent et l'approche de précision mixte. Notre guide complet sur la quantification des LLM explique pourquoi la réduction de la précision peut modifier à la fois les besoins matériels et le comportement du modèle.
Pour un responsable d'infrastructure, le principe est plus simple : les promesses d'optimisation sont bien plus utiles lorsqu'elles sont accompagnées de leur impact sur la qualité.
Le contexte est une autre raison pour laquelle le nom du modèle ne suffit pas
La précision n'est pas le seul choix de service dissimulé derrière le nom d'un modèle.
Le contexte en est un autre.
Le modèle de base Qwen3.6-27B possède une longueur de contexte native de 262 144 jetons.
La plupart des fournisseurs de ce comparatif proposent une fenêtre à peu près équivalente.
Groq propose actuellement 131 072 jetons.
Makora indique sa limite à 256K.
Cela ne rend pas un point de terminaison universellement meilleur qu'un autre. Une fenêtre de 131K dépasse déjà largement les besoins de nombreuses charges de travail en production, et Groq se montre très compétitif en termes de vitesse d'inférence.
Mais cela rend la décision d'achat dépendante de la charge de travail.
Un agent de codage qui doit conserver un vaste répertoire, des outils et un historique dans son contexte a des besoins différents de ceux d'un service de classification traitant des enregistrements courts.
« Prend en charge Qwen3.6-27B » ne répond pas à cette question.
La spécification réelle du point de terminaison, elle, y répond.
Un bon comparatif distingue « non indiqué » de « non pris en charge ».
Il existe une rigueur importante à adopter lors de la comparaison de fournisseurs.
Si un fournisseur ne publie pas une information, cela ne signifie pas que la fonctionnalité est absente.
OVHcloud peut utiliser une précision de service particulière en interne. Novita peut en faire autant.
Leurs pages publiques dédiées à Qwen3.6-27B ne l'indiquent tout simplement pas à ce jour.
Cette distinction est cruciale, car les comparatifs concurrentiels perdent rapidement toute crédibilité lorsque des informations manquantes sont présentées comme des fonctionnalités absentes.
La question pertinente n'est pas de savoir si chaque cellule d'un comparatif peut être transformée en avantage.
C'est de savoir si les informations dont un acheteur a besoin pour comprendre le produit sont disponibles.
En matière de précision, le marché progresse. DeepInfra, SiliconFlow et Makora fournissent désormais des informations utiles sur la manière dont ils servent le modèle Qwen3.6-27B. Groq explique son propre système d'optimisation numérique.
L'étape suivante consiste à en exposer les effets.
Quel est le coût du FP8 en termes de capacités du modèle pour la configuration de ce fournisseur ?
Quel est le coût du NVFP4 ?
Qu'est-ce qu'un format numérique propriétaire a changé ?
Ce sont des chiffres plus difficiles à produire.
Ils sont également plus utiles.
C'est d'autant plus important lorsque l'efficacité fait partie des arguments de vente
Une précision moindre est l'un des principaux moyens par lesquels les fournisseurs d'inférence améliorent leur efficacité.
C'est un avantage légitime.
Mais dès lors que l'efficacité devient un argument d'achat, la qualité doit rester au cœur de la discussion.
Une configuration qui utilise moins de ressources mais qui tombe en dessous de votre seuil de qualité de production n'est pas efficace pour votre charge de travail.
Une configuration qui préserve des capacités dont vous n'avez jamais besoin tout en doublant les besoins matériels peut ne pas être efficace non plus.
Le juste équilibre se situe quelque part entre ces deux extrêmes.
C'est pourquoi Hivenet Inference API est conçue pour tester le modèle par rapport à la charge de travail, plutôt que de considérer le nom d'un modèle comme une garantie d'adéquation.
Pour un déploiement en production, cela signifie examiner simultanément les prompts, le contexte, la latence, le débit, la région, la qualité du modèle et le coût.
La précision du service est un élément de ce système.
Savoir ce qu'elle a impliqué pour le modèle en fait un élément utile.
Posez une question supplémentaire lors de la comparaison des API Qwen
Le prix est facile à comparer.
La longueur du contexte est généralement facile à trouver.
Le nombre de jetons par seconde fait l'objet d'une grande attention.
Lorsque vous comparez les fournisseurs de Qwen3.6-27B, ajoutez une autre question :
Quelle version du modèle me est réellement fournie, et quel a été le coût de l'optimisation du service en termes de qualité ?
Un fournisseur doit être en mesure de vous dire comment le modèle est exécuté.
Mieux encore, il doit être en mesure de vous montrer ce que ces choix ont modifié.
Hivenet publie la précision de service de son modèle Qwen3.6-27B, l'approche de quantification utilisée et l'écart de performance mesuré par rapport à la pleine précision.
Le modèle HivenetQuant Qwen3.6-27B NVFP4 rend également le modèle lui-même inspectable.
Cela offre aux équipes quelque chose de plus utile qu'une simple promesse d'« inférence optimisée ».
Cela leur donne suffisamment d'informations pour décider si l'optimisation est adaptée à la production.
Explorer l'API d'inférence Hivenet, ou discuter avec notre équipe de la qualité du modèle, du contexte, de la région, du débit et des exigences de coût liés à votre charge de travail.
Your next workload belongs on Hivenet.
Pick one AI, compute, or storage workload and see the difference for yourself. Spin it up in minutes, or let our team map your fastest path to production.