Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Store
Accédez à vos fichiers et gérez votre compte de stockage.
Compute
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Send directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Store
Sauvegardez des photos et des fichiers sur tous vos appareils.
Compute
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir SendVous avez déjà un compte ? Connectez-vous
Que fait un architecte HPC ? Concevoir un système de calcul
Un architecte HPC conçoit des environnements de calcul pour des traitements scientifiques, techniques et de données exigeants. Il traduit les besoins des applications en choix de processeurs, de mémoire, de réseau, de stockage, d'ordonnancement et de logiciels, puis vérifie que l'ensemble fournit des résultats utiles dans les délais et le budget du projet.
Ce guide s'adresse aux chercheurs, aux ingénieurs et aux équipes qui préparent leur infrastructure. Il explique les décisions derrière une machine puissante, un cluster ou un déploiement cloud, avec un schéma de référence et une liste de vérification pratique.
Que fait un architecte HPC ?
L'architecte fait le lien entre les personnes qui utilisent les applications et celles qui fournissent l'infrastructure. Il produit notamment un profil des traitements, un schéma d'architecture, une proposition de dimensionnement, un plan de tests et des décisions documentées sur la sécurité, l'exploitation et les coûts. La conception doit préciser les objectifs du système et la manière de vérifier qu'ils sont atteints.
Ce travail dépasse le choix des serveurs. Un processeur rapide peut passer une grande partie de son temps à attendre la mémoire, un autre processus ou un disque partagé. Une application peut aussi dépendre d'un compilateur, d'un environnement d'accélération ou d'une licence logicielle particulière. Ces contraintes doivent être connues avant de commander le matériel ou de lancer les instances.
L'architecte HPC pilote généralement les besoins et les décisions de conception. L'ingénieur ou l'administrateur HPC intervient davantage dans la mise en œuvre, l'exploitation et le dépannage. Ces responsabilités se recoupent, surtout dans les petites équipes, et les observations de terrain doivent nourrir la conception.
Partir du traitement et du résultat attendu
Commencez par une application représentative et un objectif mesurable : terminer une simulation validée avant une échéance, traiter un lot quotidien ou accueillir plusieurs équipes de recherche avec des temps d'attente acceptables. Relevez la durée actuelle et les étapes nécessaires pour obtenir un résultat exploitable.
Calcul : quelles étapes utilisent les CPU ou les GPU, et l'application prend-elle en charge plusieurs accélérateurs ou nœuds ?
Mémoire : quel est le besoin maximal, et quelle quantité doit tenir dans chaque nœud ou GPU ?
Communication : à quelle fréquence les tâches parallèles échangent-elles des données ou s'attendent-elles ?
Données : quels sont le volume d'entrée, le profil de lecture et d'écriture, la fréquence des points de reprise et les besoins de conservation ?
Exploitation : quels sont les délais, le nombre de tâches simultanées, les licences, les règles d'accès et les exigences de reprise ?
Examinez toute la chaîne de traitement. Un solveur peut être fortement couplé alors que son prétraitement et ses études paramétriques indépendantes ne le sont pas. La méthode de conception HPC de Microsoft place ces échanges parmi les premières décisions, car ils influencent le calcul, le réseau et le placement des ressources.
Les tâches couplées et indépendantes demandent des conceptions différentes
Dans une tâche fortement couplée, les processus échangent fréquemment des données pour résoudre un même problème. Un solveur distribué de mécanique des fluides peut avoir besoin des résultats des zones voisines du maillage pour avancer. Lorsque le calcul s'étend à plusieurs nœuds, les délais réseau et la synchronisation peuvent limiter le gain apporté par des processeurs supplémentaires.
Les traitements faiblement couplés regroupent des tâches largement indépendantes, comme des images de rendu distinctes ou une étude paramétrique. La conception peut privilégier le nombre de tâches terminées par heure, une distribution fiable du travail et une préparation efficace des données. Même indépendantes, les tâches peuvent saturer un stockage partagé ou épuiser les licences lorsqu'elles démarrent ensemble.
Pour plusieurs nœuds, évaluez la latence, la bande passante utile, les bibliothèques de communication et le placement. Les recommandations réseau HPC d'AWS rappellent aussi que certaines applications fortement couplées tiennent dans une seule grande instance et évitent ainsi les communications entre nœuds. InfiniBand, RoCE et les autres réseaux spécialisés sont des options à évaluer selon le traitement, pas des obligations universelles.
Choisir ensemble le calcul et la mémoire
Le choix d'un CPU dépend de l'application : performances par cœur, nombre de cœurs, instructions vectorielles, capacité et bande passante mémoire peuvent tous compter. Ajouter des cœurs apporte peu si le programme ne les utilise pas ou s'ils se disputent un accès mémoire saturé. Sur une machine à plusieurs sockets, testez le placement des processus et l'accès à la mémoire locale ou distante.
Un GPU est utile si l'application dispose d'un mode d'accélération compatible. Vérifiez la précision numérique requise, la mémoire GPU disponible, les bibliothèques prises en charge et les étapes qui restent sur CPU. Un GPU adapté à l'apprentissage automatique en précision réduite peut mal convenir à un solveur exigeant de bonnes performances en double précision.
Avec plusieurs GPU, examinez comment l'application répartit les données et communique entre les périphériques. Plusieurs GPU ne constituent pas automatiquement un appareil unique doté d'une mémoire commune. Le modèle ou le solveur doit prendre en charge une stratégie de distribution adaptée.
Le tutoriel de calcul parallèle de Lawrence Livermore explique la mémoire partagée et distribuée ainsi que les coûts de communication et de synchronisation. Ces mécanismes justifient de mesurer le passage à l'échelle avec l'application réelle plutôt que de le déduire du nombre de processeurs.
Dimensionner le stockage selon les accès et la durée de conservation
Séparez l'espace de travail temporaire des entrées et résultats à conserver. Le NVMe local peut accueillir les fichiers temporaires et les caches ; un stockage de fichiers partagé donne accès à un espace de noms commun depuis plusieurs machines. Un système de fichiers parallèle peut se justifier lorsque l'application exige des accès fichiers partagés et un débit cumulé élevé entre les nœuds.
Le stockage objet propose une autre interface pour les jeux de données, les sorties et les archives. Les applications peuvent y accéder directement ou transférer les données vers un système de fichiers avant le calcul. La compatibilité S3 ne suffit pas à fournir le comportement d'un système de fichiers POSIX. Notre guide des systèmes de fichiers HPC explique ces différences et les mesures utiles pour repérer une limite d'entrées-sorties.
Suivez chaque jeu de données depuis son arrivée jusqu'à son traitement, ses points de reprise, son export et sa suppression. Précisez son responsable et ce qui subsiste après l'échec d'une tâche ou la suppression d'une instance. Testez le redémarrage depuis un point de reprise : la présence d'un fichier ne prouve pas que la récupération fonctionne.
Intégrer l'ordonnancement et les logiciels à l'architecture
Un ordonnanceur attribue les ressources et détermine les tâches en attente qui peuvent démarrer. La documentation de Slurm décrit l'allocation des ressources, l'exécution et le suivi des tâches ainsi que la gestion de la file d'attente comme ses fonctions principales. Slurm est une option pour les clusters partagés ; un traitement plus simple sur instances peut utiliser une file légère ou les commandes de l'application.
Définissez les ressources demandées par une tâche : cœurs CPU, mémoire, GPU, durée et licences limitées. Décidez des priorités et des plafonds lorsque plusieurs équipes utilisent la même capacité. La politique d'ordonnancement influence les temps d'attente et l'équité, même si le matériel est performant.
Le plan logiciel doit consigner le système d'exploitation, les pilotes, les compilateurs, l'implémentation MPI, les bibliothèques numériques, la version de l'application et les licences. Les conteneurs et les modules d'environnement facilitent la reproduction des configurations, mais la compatibilité avec les pilotes de l'hôte et le matériel réseau reste à tester.
Conservez les définitions d'infrastructure et les configurations dans un système de gestion de versions. Les blueprints de Cluster Toolkit de Google illustrent des configurations réutilisables décrivant les composants d'un cluster et leurs dépendances. Quel que soit l'outil, vérifiez qu'un autre membre de l'équipe peut recréer l'environnement à partir de la configuration enregistrée.
Schéma d'architecture HPC : un modèle de référence
Le schéma distingue la soumission des tâches des chemins empruntés pour lire, écrire et échanger les données. La supervision, les règles d'accès et le suivi des coûts concernent tout le système ; ils ne constituent pas une dernière étape après le stockage.
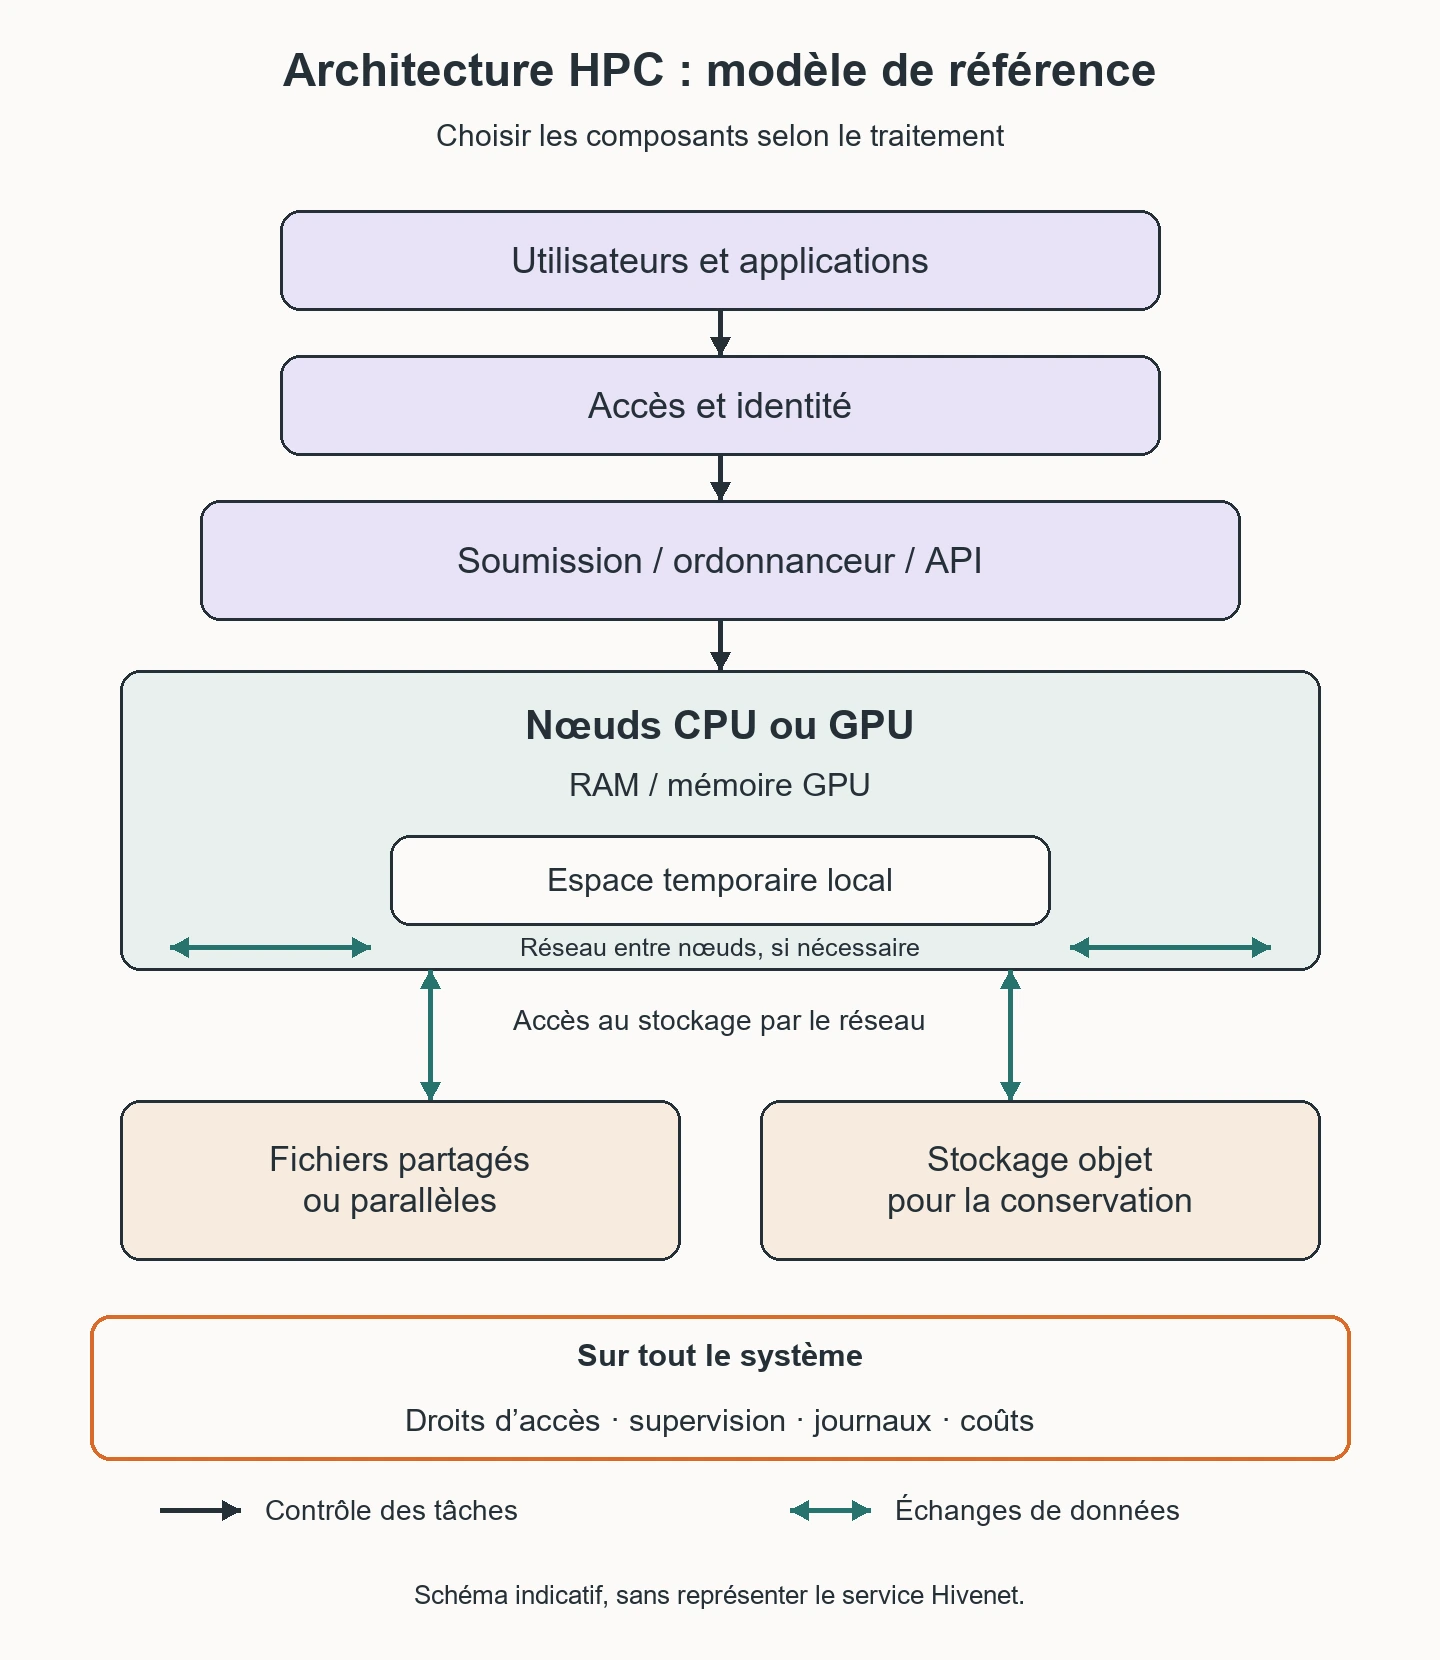
Les utilisateurs s'authentifient et soumettent le travail par une interface autorisée. Un ordonnanceur ou un contrôleur de tâches attribue les ressources. Les nœuds de calcul utilisent leur espace temporaire local et, si nécessaire, un stockage de fichiers ou objet accessible par le réseau. Plusieurs nœuds échangent des données par une interconnexion lorsque l'application le demande.
Il s'agit d'un modèle de référence, pas d'une topologie obligatoire ni d'un schéma du service Hivenet. Un traitement sur un seul nœud peut se passer du réseau entre nœuds, et un lot de tâches indépendantes n'exige pas forcément un système de fichiers parallèle.
Choisir un déploiement sur site, cloud ou hybride
Une infrastructure sur site peut convenir à une demande prévisible, à du matériel spécialisé ou à des données coûteuses à déplacer. Comptez l'électricité, le refroidissement, la maintenance, la planification de capacité et le personnel d'exploitation. Une utilisation soutenue peut améliorer les coûts, sans garantir à elle seule le coût total le plus bas.
Le HPC dans le cloud peut fournir une capacité temporaire ou permettre de tester des configurations avant un engagement plus long. Vérifiez la disponibilité, les quotas, le temps de transfert, les licences et les options réelles de réseau et de stockage. Le cloud exige toujours une conception adaptée au traitement.
Le HPC hybride combine plusieurs environnements. Il peut maintenir un traitement près de ses données tout en déplaçant des tâches indépendantes, mais ajoute des besoins d'identité, de synchronisation, de cohérence logicielle et d'ordonnancement. La présentation des architectures HPC d'Intel décrit les approches cloud et hybrides ; le bon placement dépend néanmoins du comportement mesuré des applications.
Une équipe peut, par exemple, conserver un solveur fortement couplé sur son cluster et tester des instances cloud pour des études paramétriques indépendantes. C'est une possibilité à vérifier, pas une preuve que toute simulation fonctionnera efficacement dans les deux environnements.
Définir la sécurité, la reprise et les responsabilités d'exploitation
Documentez qui peut soumettre des tâches, administrer les nœuds, lire les données partagées et modifier les images ou modèles. Séparez les droits des utilisateurs et de l'automatisation, protégez les secrets et limitez l'exposition des interfaces d'administration. Un réseau privé ne remplace ni le contrôle d'accès ni la maintenance logicielle.
Attribuez la responsabilité des mises à jour, des tâches en échec, de la conservation des sauvegardes et de la réponse aux incidents. Déterminez ce qui se passe lorsqu'un nœud tombe en panne, qu'un serveur de licences devient inaccessible ou qu'une limite de stockage est atteinte. Les exigences de reprise doivent guider le placement des points de reprise, la documentation des configurations et la capacité de réserve.
Suivez les temps d'attente, les tâches terminées avec des résultats valides, l'utilisation des ressources, les attentes d'entrées-sorties et les coûts par projet. Ces mesures aident à distinguer une application lente d'un système encombré et à évaluer l'utilisation de la capacité.
Quelles compétences faut-il à un architecte HPC ?
Le métier associe Linux et l'administration système au calcul parallèle, au matériel CPU/GPU, au réseau, au stockage, aux ordonnanceurs et aux environnements logiciels. Le profilage, l'automatisation, la sécurité et l'analyse des coûts permettent de transformer ces connaissances en une conception exploitable.
Comprendre les besoins et les documenter clairement compte autant que connaître les outils. L'architecte doit demander au chercheur ce qui constitue un résultat valide, expliquer les compromis au responsable du budget et fournir aux équipes d'exploitation un système maintenable. Aucun seuil d'expérience ni aucune certification ne s'applique universellement à tous les postes d'architecte HPC.
Quelle place pour Compute with Hivenet ?
Compute with Hivenet propose des instances CPU et GPU qu'un architecte peut évaluer dans une conception plus large. Les usages possibles comprennent les applications compatibles sur un seul nœud, les simulations indépendantes, le rendu et les environnements de développement ou de test. L'application, la configuration choisie et les exigences d'exploitation déterminent leur adéquation.
La FAQ Compute documente les options de conteneurs et de machines virtuelles, l'accès SSH et le stockage NVMe. Vérifiez la configuration actuelle et le cycle de vie du stockage avant d'y conserver des données de recherche. Testez une tâche représentative et confirmez que ses résultats peuvent être récupérés.
Pour des calculs fortement couplés sur plusieurs nœuds, confirmez avec Hivenet le réseau, la compatibilité MPI, l'ordonnancement, le stockage partagé et le support. La disponibilité d'instances ne démontre pas à elle seule l'existence d'un cluster HPC géré, d'un système de fichiers POSIX parallèle ou d'un niveau précis de performance d'interconnexion.
Une liste de vérification pour l'architecture HPC
Définissez le résultat, l'échéance, le profil du traitement et les critères d'acceptation.
Mesurez une configuration de référence et repérez les limites de calcul, de mémoire, de communication et d'entrées-sorties.
Sélectionnez des composants adaptés et documentez les contraintes logicielles, de licences, d'accès et de localisation des données.
Testez toute la chaîne, y compris les transferts préparatoires, les tâches simultanées, les pannes et la reprise.
Comparez le délai complet et le coût total, puis consignez la configuration et les raisons du choix.
Gardez des entrées de test et des critères de validation cohérents entre configurations. Incluez l'attente, la préparation, les transferts, le stockage, les licences, les échecs et le travail d'exploitation. Un calcul plus court peut malgré tout donner une chaîne globale plus lente ou plus chère.
Questions fréquentes
Une architecture HPC implique-t-elle toujours un cluster ?
Non. Un traitement peut fonctionner sur une grande machine CPU ou un nœud équipé d'un GPU. Utilisez plusieurs nœuds lorsque l'application les prend en charge et que la capacité supplémentaire ou l'accélération mesurée justifie la complexité.
L'architecte HPC écrit-il le code des applications ?
Le rôle peut comprendre des scripts, de l'automatisation, du profilage et une collaboration aux modifications applicatives. La responsabilité du code scientifique dépend de l'équipe. L'architecte doit suffisamment comprendre son comportement pour choisir et valider l'infrastructure.
Faut-il toujours des GPU, Slurm ou un système de fichiers parallèle ?
Non. Ce sont des choix de conception. La prise en charge des accélérateurs, l'ordonnancement, les accès aux données, l'échelle et les contraintes d'exploitation déterminent les composants utiles.
Comment vérifier que l'architecture remplit ses objectifs ?
Le système produit des résultats valides en respectant les exigences convenues de délai, de coût, de sécurité et de reprise, sous une charge représentative. Les performances maximales du matériel apportent une information complémentaire ; elles ne constituent pas le test d'acceptation.
Votre prochaine charge de travail sur Hivenet.
Choisissez une charge de travail d’IA, de calcul ou de stockage à tester sur Hivenet, ou échangez avec notre équipe sur sa mise en production.