

Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Store
Accédez à vos fichiers et gérez votre compte de stockage.
Compute
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Send directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Store
Sauvegardez des photos et des fichiers sur tous vos appareils.
Compute
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir SendVous avez déjà un compte ? Connectez-vous
Systèmes décentralisés et systèmes distribués : quelle est la différence ?
Contexte historique : cet article a été publié en janvier 2023. Les passages sur le réseau pair à pair décrivent le modèle présenté à cette époque, pas une garantie sur les produits actuels. Consultez la présentation actuelle de l'infrastructure Hivenet et la page Store pour distinguer les produits. Distribué décrit la répartition des composants ; décentralisé décrit la répartition du contrôle.
Les termes « décentralisé » et « distribué » décrivent deux aspects d'un système : qui le contrôle et où se trouvent ses composants. Ils peuvent se combiner, mais ne sont pas synonymes.
Voici comment distinguer ces deux notions.
Systèmes décentralisés : un contrôle réparti
Dans un système centralisé, une autorité coordonne ou contrôle les décisions essentielles. Dans un système décentralisé, ce contrôle est réparti entre plusieurs acteurs. Il faut préciser de quel contrôle on parle : gouvernance, validation des opérations ou gestion des données. La présence d'un composant central ne suffit pas à décrire toute l'architecture.
En bref : la décentralisation concerne la répartition du contrôle, pas une garantie de transparence ou de sécurité.
Systèmes distribués : des composants en réseau
Un système distribué réunit plusieurs composants qui communiquent par un réseau. Il peut répartir le stockage ou les calculs entre plusieurs machines tout en conservant une coordination centrale. Ses performances dépendent notamment du réseau, des tâches et des mécanismes de coordination.
En bref : la distribution concerne la répartition des composants. Elle peut coexister avec un contrôle centralisé ou décentralisé.
Distribué et décentralisé : deux critères distincts
Un système peut être distribué sans être décentralisé : plusieurs serveurs peuvent appartenir au même opérateur et suivre ses décisions. À l'inverse, répartir le contrôle ne décrit pas à lui seul l'emplacement du matériel. Pour l'aspect physique, consultez notre guide sur les emplacements du stockage cloud.
Les tableaux ci-dessous présentent des avantages et des limites possibles. Ils ne permettent pas de prédire les résultats d'un service précis : ceux-ci dépendent de sa conception et de son exploitation.
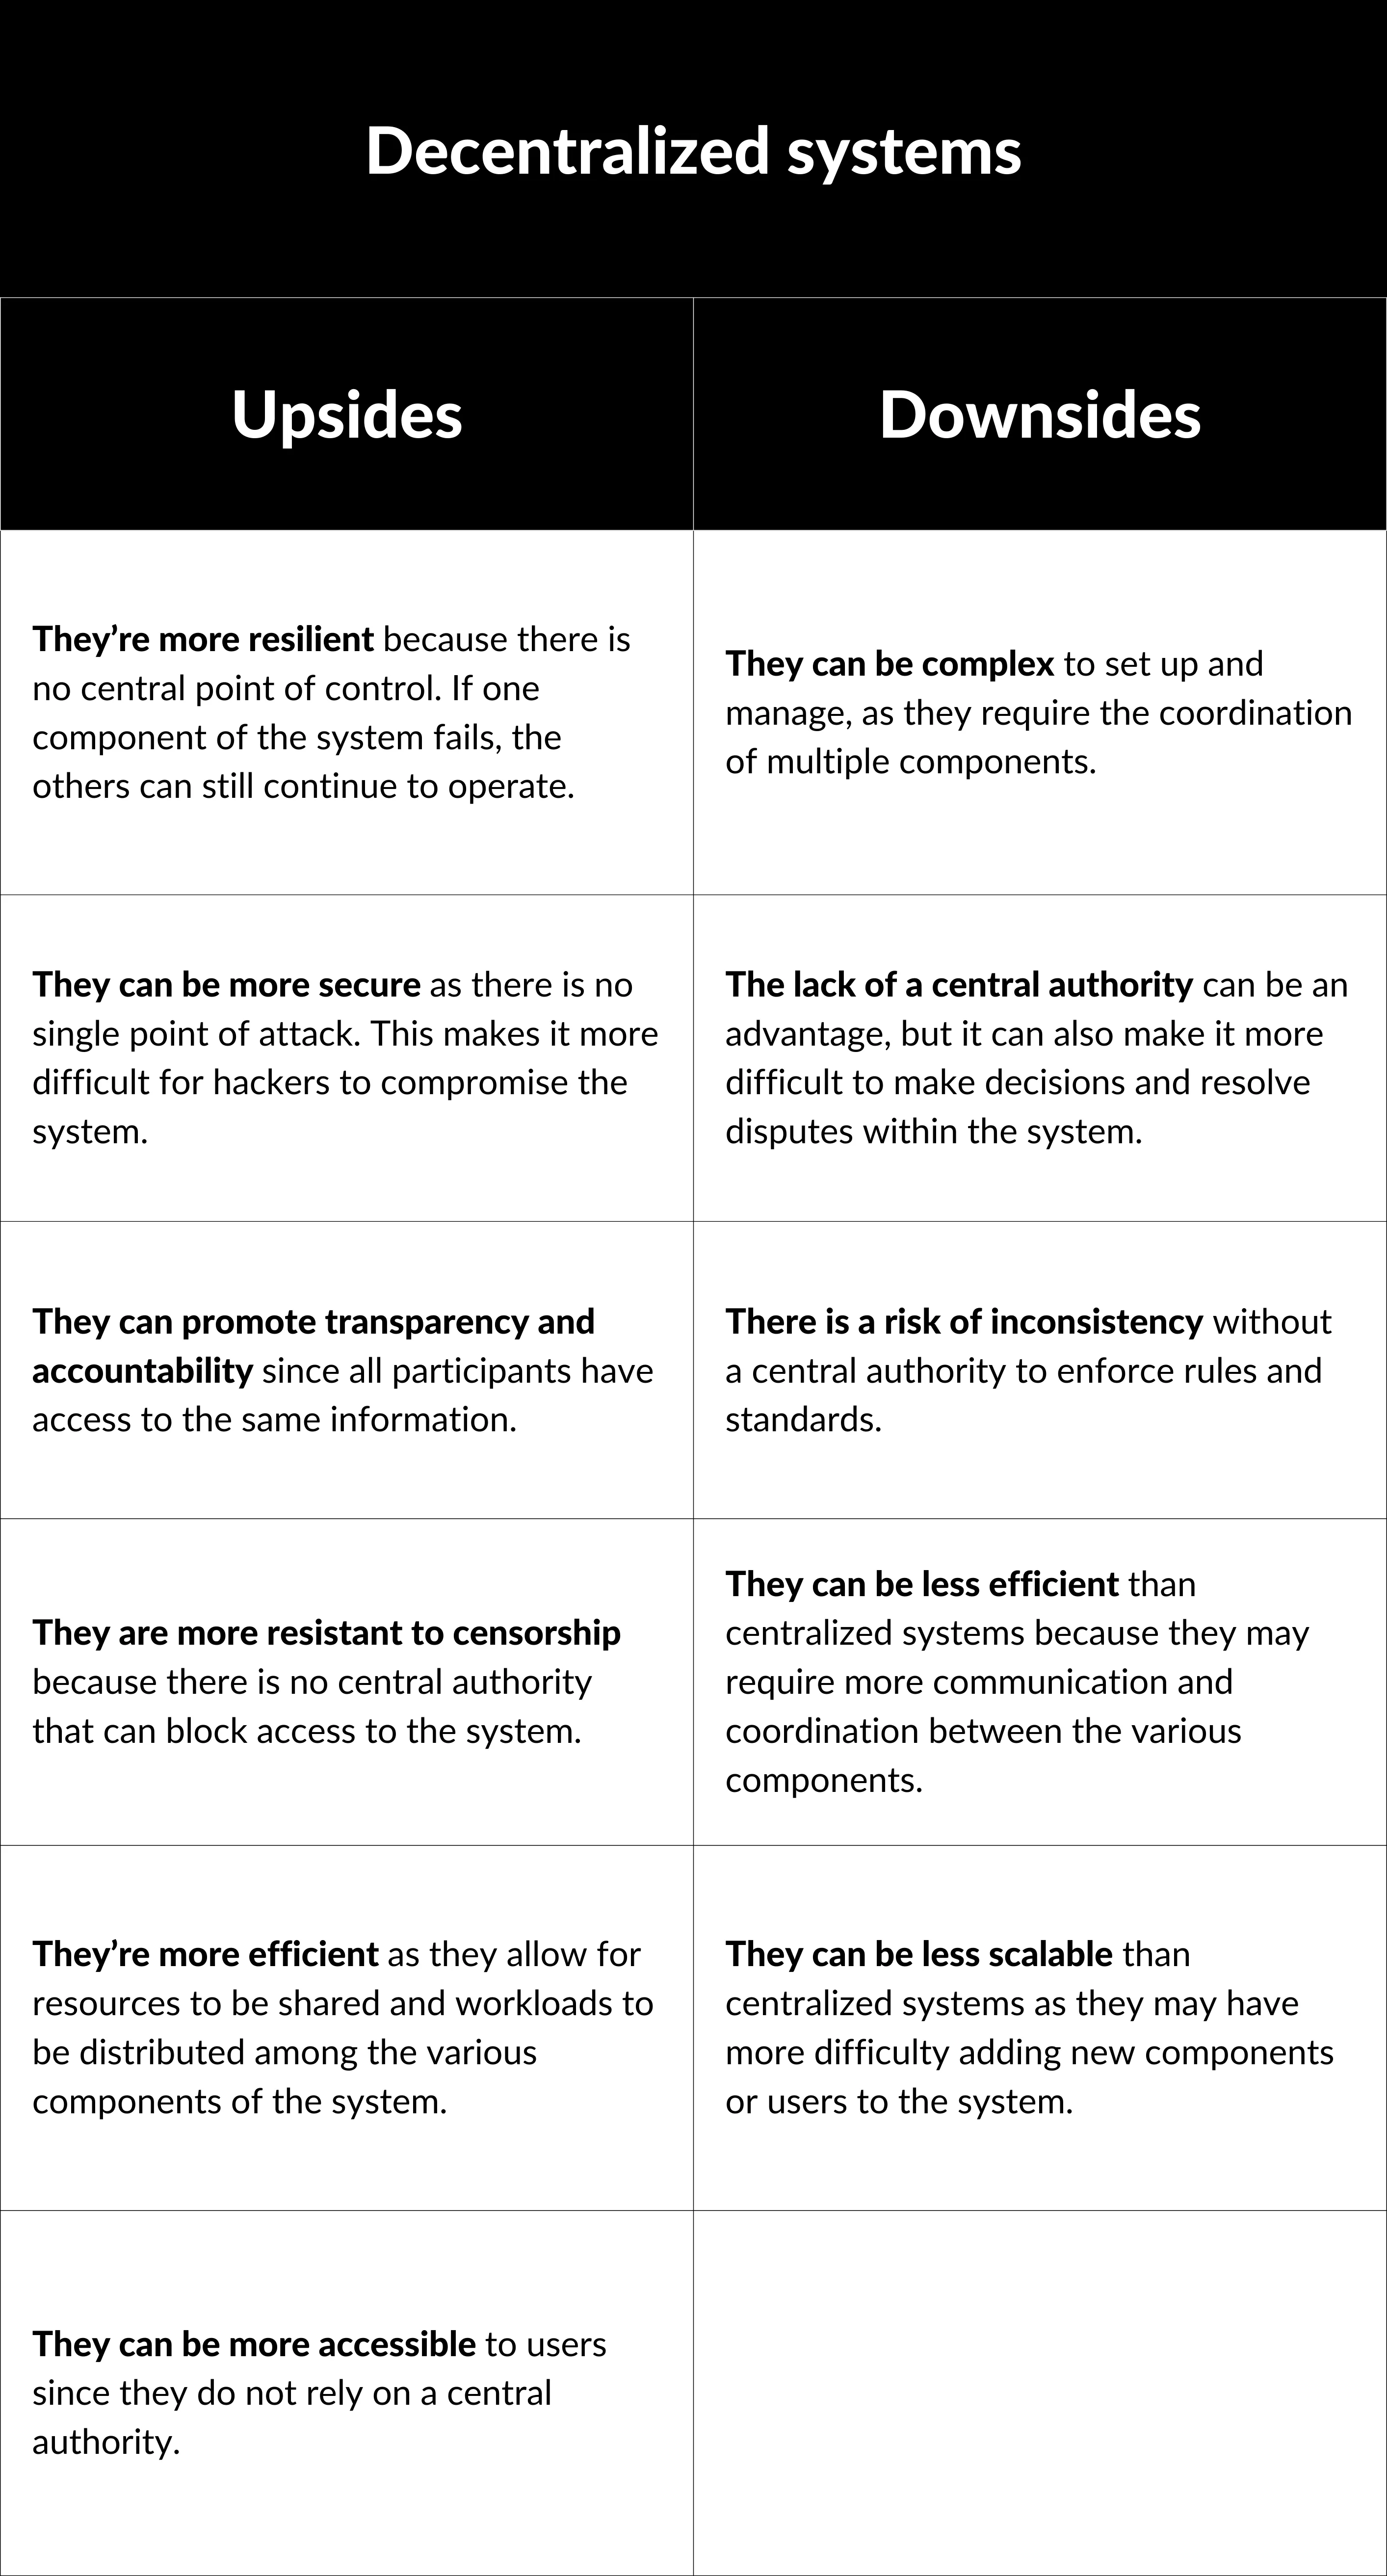
La complexité, la transparence et la capacité à évoluer dépendent de l'implémentation. Pour comparer des systèmes, examinez les responsabilités de chaque acteur, les dépendances centrales, les risques de panne et les mesures de protection.

Choisir un modèle selon les besoins
Les modèles centralisés, décentralisés et distribués répondent à des besoins différents ; ils ne forment pas une succession obligatoire. La sécurité, la tolérance aux pannes et les coûts dépendent de la conception et de l'exploitation. La distribution ne garantit pas automatiquement de meilleures performances ou une baisse des coûts.
Le modèle Hivenet présenté en janvier 2023
La description de janvier 2023 présentait un stockage réparti entre des ordinateurs participants, avec une couche d'échange pair à pair et des services coordonnés par Hivenet. Ces éléments historiques ne prouvent pas que les produits actuels sont hébergés sur l'ordinateur de chaque utilisateur, ni que les fichiers peuvent toujours être récupérés sans service central. Les architectures actuelles doivent être examinées produit par produit.
Les questions suivantes complètent ces distinctions.
Questions fréquentes
Quels sont quelques exemples de systèmes centralisés, décentralisés et distribués ?
Dropbox et Google Drive illustrent des services dont la gestion relève d'un opérateur. Cela ne signifie pas que leur infrastructure physique se limite à un seul serveur.
BitTorrent distribue les échanges de fichiers entre pairs. La découverte des pairs peut utiliser un serveur de suivi (« tracker ») ou une table de hachage distribuée (DHT). Le pair à pair ne signifie donc pas que tous les composants sont décentralisés. Les spécifications BEP 3 et BEP 5 décrivent ces mécanismes (en anglais).
Un groupe de machines qui se partage les tâches de rendu d'une animation 3D illustre un système distribué. Il peut utiliser un ordonnanceur central : la répartition des calculs ne suppose pas une répartition du contrôle.
Comment le modèle historique de Hivenet utilisait-il le pair à pair ?
L'exemple historique décrivait 100 fragments chiffrés dont 70 suffiraient à reconstruire un fichier, avec régénération des fragments manquants. Il illustre un principe de redondance, pas un paramètre actuel garanti de Store. Trente fragments sur cent représentent 30 % du total stocké ; par rapport aux 70 fragments nécessaires, le supplément est d'environ 43 %, si les fragments ont la même taille. Une probabilité de disponibilité exige aussi des hypothèses sur les pannes et la réparation. La note technique de novembre 2022 (en anglais) conserve le contexte d'origine.
Consultez nos articles en français pour approfondir ces sujets.
Comment comparer l'architecture et le contrôle d'un système ?
Posez deux questions séparées : où les composants fonctionnent-ils, et qui prend les décisions ? Un opérateur peut contrôler un service réparti sur de nombreuses machines. Un échange entre pairs peut aussi dépendre de services centraux pour certaines fonctions. Examinez chaque couche avant de qualifier l'ensemble du système.
Que montre l'exemple historique sur la disponibilité des données ?
Le modèle historique utilisait la redondance et la réparation pour limiter les effets des pannes ou du départ de participants. L'exemple de 100 fragments dont 70 nécessaires à la reconstruction ne constitue ni une configuration actuelle garantie, ni un engagement de disponibilité. Pour les fichiers conservés dans Store aujourd'hui, vérifiez les conditions du service et gardez une sauvegarde indépendante.
Quels défis faut-il examiner avant d'adopter un système distribué ?
Examinez la compatibilité avec vos applications, les échanges réseau, la cohérence des données, la sécurité et la récupération après panne. Une répartition sur plusieurs machines ajoute des dépendances et des besoins de supervision. Testez les performances et les procédures de reprise avec vos propres charges de travail avant de conclure que le modèle répond à vos besoins.
Votre prochaine charge de travail sur Hivenet.
Choisissez une charge de travail d’IA, de calcul ou de stockage à tester sur Hivenet, ou échangez avec notre équipe sur sa mise en production.

