

Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Store
Accédez à vos fichiers et gérez votre compte de stockage.
Compute
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Send directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Store
Sauvegardez des photos et des fichiers sur tous vos appareils.
Compute
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir SendVous avez déjà un compte ? Connectez-vous
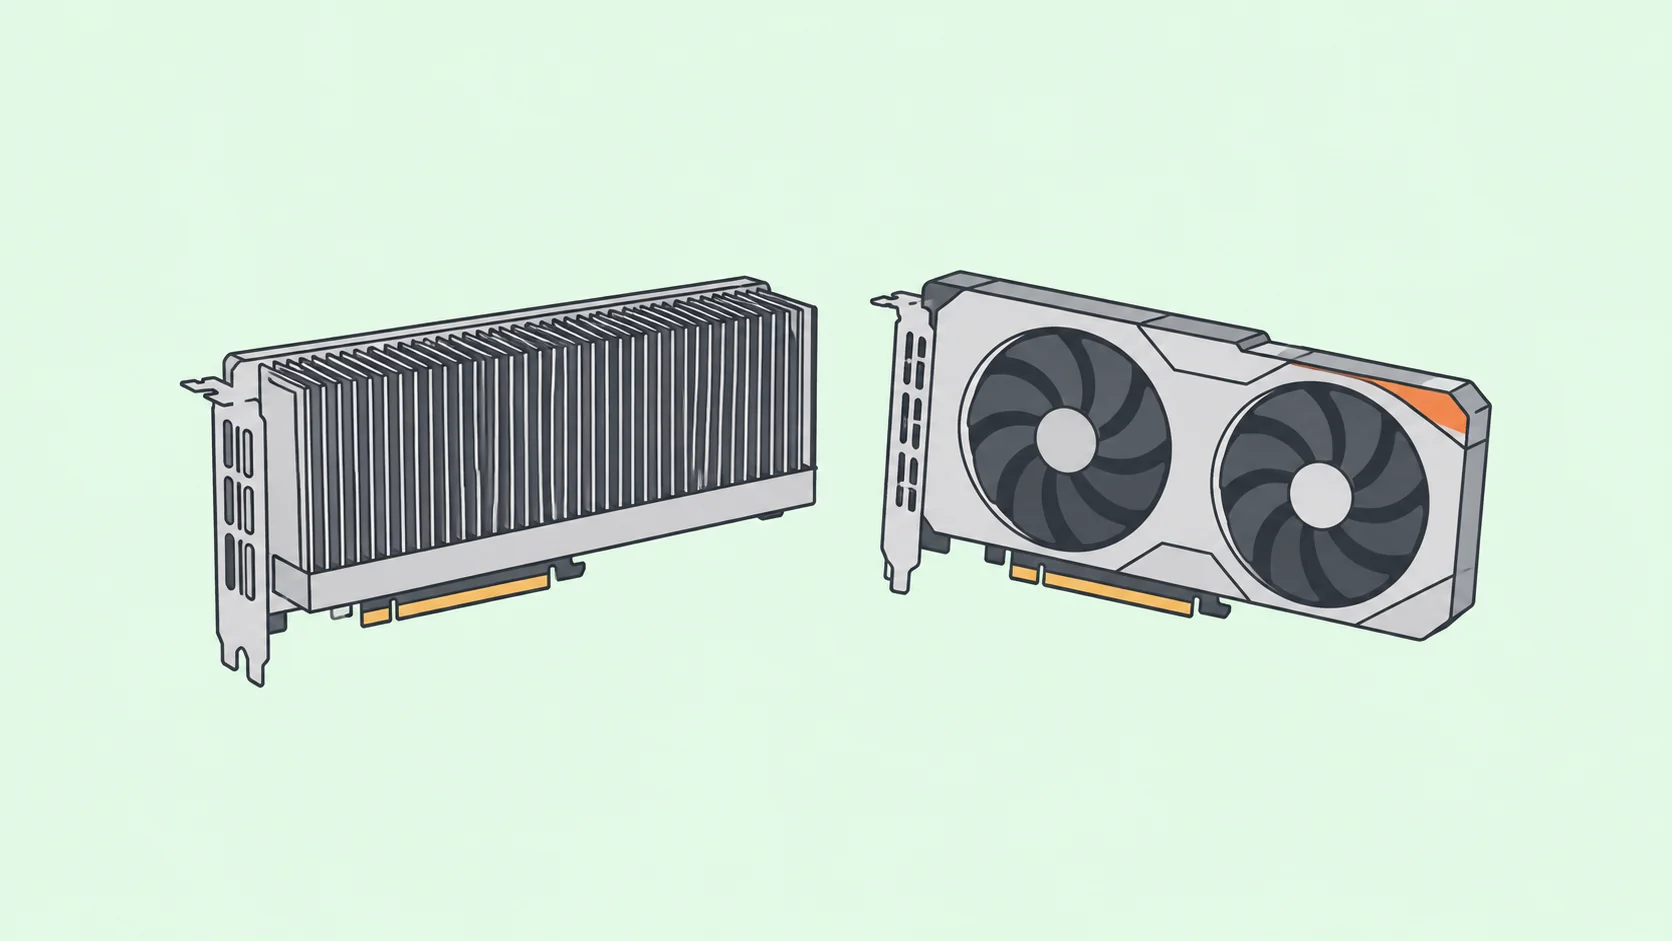
NVIDIA A40 ou RTX 3090 : mémoire, performances et déploiement
Le NVIDIA A40 et le GeForce RTX 3090 sont deux GPU Ampere aux exigences de déploiement différentes. L’A40 dispose de 48 Go de GDDR6 avec ECC et d’un refroidissement passif destiné aux serveurs adaptés. Le RTX 3090 possède 24 Go de GDDR6X et une bande passante mémoire nominale supérieure, avec un refroidissement actif sur les cartes de bureau. Le choix dépend de la charge à exécuter, des logiciels nécessaires et du système qui accueillera la carte.
Ce comparatif porte sur l’IA, le rendu et le calcul professionnel. Il distingue les spécifications du fabricant des performances applicatives : les chiffres ci-dessous sont des limites de référence, pas les résultats d’un test A40 contre RTX 3090 réalisé dans des conditions identiques.
NVIDIA A40 ou RTX 3090 : les principales caractéristiques
| Caractéristique | NVIDIA A40 | GeForce RTX 3090 |
|---|---|---|
| Architecture | Ampere, GA102 | Ampere, GA102 |
| Mémoire GPU | 48 Go de GDDR6 avec ECC | 24 Go de GDDR6X |
| Bande passante mémoire | 696 Go/s | 936 Go/s |
| Cœurs CUDA | 10 752 | 10 496 |
| Débit FP32 maximal, hors Tensor Cores | 37,4 TFLOPS | 35,6 TFLOPS |
| Débit Tensor TF32 dense maximal | 74,8 TFLOPS | 35,6 TFLOPS |
| Puissance de référence de la carte | 300 W | 350 W |
| Refroidissement | Passif ; flux d’air fourni par le système | Actif ; conception variable selon le fabricant |
| Interface hôte | PCIe 4.0 x16 | PCIe 4.0 |
| NVLink | Connexion de deux GPU prise en charge | Pris en charge avec un pont compatible |
Sources : fiche technique de l’A40, spécifications de référence du RTX 3090 et livre blanc de l’architecture GA102 de NVIDIA, vérifiés le 19 octobre 2026. Les chiffres du RTX 3090 correspondent au modèle de référence ; les cartes des partenaires peuvent différer. Ne les confondez pas avec ceux du RTX 3090 Ti.
Commencez par la capacité mémoire et la marge disponible
L’A40 possède deux fois plus de VRAM nominale. C’est utile lorsque l’ensemble des données nécessaires à l’exécution dépasse la mémoire disponible d’un RTX 3090, mais cela ne signifie pas que le traitement sera deux fois plus rapide. La capacité détermine ce qui peut rester sur le GPU ; la bande passante décrit la vitesse de circulation des données dans son sous-système mémoire.
Pour l’entraînement, comptez les poids, les gradients, l’état de l’optimiseur, les activations et les tampons temporaires. Pour l’inférence, ajoutez aux poids les allocations du moteur d’exécution et le cache KV nécessaire au contexte et aux requêtes simultanées. La taille du fichier du modèle ne suffit pas pour dimensionner un déploiement.
Le document technique de l’A40 précise que la capacité nominale inclut les allocations du pilote et la redondance ECC lorsqu’elle est activée. Gardez une marge et mesurez la mémoire effectivement disponible. Une charge estimée à un peu moins de 48 Go n’est pas assurée de tenir.
Que faire si 24 Go ne suffisent pas ?
Identifiez d’abord l’allocation à l’origine du problème. Réduire le micro-lot peut diminuer la mémoire des activations ; accumuler les gradients permet de conserver un lot effectif plus important sur plusieurs étapes. Cette technique ne réduit pas, à elle seule, les poids du modèle ou l’état de l’optimiseur. Quantification, recalcul des activations, déchargement vers la mémoire hôte et partitionnement agissent sur des postes différents, avec leurs propres contraintes de compatibilité et de performance.
Si l’application prise en charge tient avec une marge suffisante sur un A40, cette solution peut simplifier le déploiement par rapport à une répartition sur plusieurs GPU plus petits. Si elle tient déjà sur un RTX 3090, la VRAM supplémentaire inutilisée peut apporter peu d’avantages. Testez les entrées les plus volumineuses prévues et une concurrence réaliste, au-delà du simple chargement du modèle.
Quel GPU offre les meilleures performances ?
Ces spécifications ne permettent pas de désigner un vainqueur universel. Une charge peut être limitée par les échanges mémoire, le débit de calcul, le prétraitement CPU, le stockage ou les communications. Un composant plus rapide n’aide que s’il améliore le facteur qui limite réellement cette charge.
Bande passante et débit des Tensor Cores : deux avantages distincts
La bande passante nominale supérieure du RTX 3090 peut profiter aux traitements qui sollicitent fortement la mémoire et tiennent dans sa VRAM. L’A40 affiche un débit supérieur dans certains modes des Tensor Cores. NVIDIA indique, par exemple, des maxima TF32 denses de 74,8 TFLOPS pour l’A40 et de 35,6 pour le RTX 3090. Ces chiffres concernent un mode numérique précis, pas une vitesse d’entraînement mesurée.
Lorsque vous consultez des tests GPU, relevez la précision, le mode d’accumulation et l’utilisation éventuelle de la parcimonie structurée. Les débits denses et les débits exploitant cette parcimonie ne sont pas interchangeables. Un nombre proche de cœurs CUDA ne garantit pas non plus un comportement équivalent en précision mixte. Vérifiez que l’application emploie les noyaux adaptés et que ses résultats numériques restent acceptables.
Un test utile compare le même travail
- Utilisez le même modèle ou la même scène, les mêmes données, le même objectif de qualité et les mêmes versions logicielles. Consignez le GPU, le pilote, l’environnement CUDA, les réglages de puissance et les conditions de refroidissement.
- Mesurez le pic de VRAM et les performances soutenues après la phase de chauffe. Séparez le chargement et la compilation de l’exécution stabilisée, tout en conservant la durée totale pour calculer le coût.
- Pour l’entraînement, indiquez le nombre d’échantillons ou de jetons par seconde, la taille effective du lot et la qualité de validation. Pour un service d’inférence, mesurez latence et débit avec la longueur de contexte et le nombre de requêtes simultanées prévus.
- Répétez le test et cherchez la cause des variations. Un pic de performance avant une réduction de fréquence due à la chaleur ne décrit pas correctement un travail long.
- Comparez le coût par tâche terminée ou par résultat exploitable. Un tarif horaire inférieur peut perdre son avantage si le même travail prend davantage de temps ou exige plus de GPU.
Cet article n’attribue pas un avantage fixe en pourcentage à l’entraînement de LLM, à la vision par ordinateur, à l’inférence ou au rendu. Il faudrait pour cela un test reproductible dans des conditions comparables. Un résultat obtenu sur un autre modèle ou avec une autre précision peut orienter une hypothèse, sans trancher votre choix.
Refroidissement, alimentation et compatibilité physique
Le dissipateur passif de l’A40 dépend du flux d’air fourni par un châssis compatible. Il ne s’agit pas d’une carte de bureau silencieuse pouvant fonctionner sans refroidissement. Vérifiez les configurations GPU prises en charge par le serveur, le sens du flux d’air, l’alimentation et les outils de gestion avant d’envisager son installation dans une station de travail.
NVIDIA spécifie un connecteur d’alimentation auxiliaire à huit broches de type CPU pour l’A40. Le RTX 3090 Founders Edition utilise un montage différent. Suivez la documentation de la carte et du système concernés ; la forme d’un connecteur ne suffit pas à établir sa compatibilité électrique.
Le RTX 3090 Founders Edition occupe trois emplacements, contre deux pour l’A40. Les cartes 3090 des partenaires ont leurs propres dimensions et systèmes de refroidissement. Vérifiez l’espace disponible, l’écartement entre les cartes et la capacité à évacuer la chaleur sous charge prolongée.
Une puissance de référence de 300 W contre 350 W ne prouve pas un gain d’efficacité énergétique en pourcentage. Mesurez l’énergie consommée par le système complet pour accomplir la même tâche. Le CPU, les ventilateurs, le taux d’utilisation, la durée et le refroidissement du site influencent le résultat. La puissance d’alimentation recommandée sert aussi à dimensionner le système ; elle n’est pas la consommation permanente du GPU.
ECC, virtualisation et déploiement multi-GPU
L’ECC de l’A40 mérite d’être pris en compte lorsque la gestion des erreurs mémoire est importante. Il ne garantit ni un logiciel correct, ni des calculs sans défaillance, ni la disponibilité de l’application. Examinez les dispositifs de surveillance des erreurs et de reprise du système complet.
L’A40 prend en charge NVIDIA vGPU dans les déploiements compatibles. Consultez les plateformes actuellement validées et la licence requise pour votre profil et votre usage. L’achat de la carte n’inclut pas toutes les fonctions de virtualisation. L’A40 ne prend pas en charge Multi-Instance GPU (MIG) : le support vGPU ne doit donc pas être présenté comme un partitionnement matériel MIG.
NVLink additionne-t-il automatiquement les mémoires ?
Les deux produits prennent en charge une connexion NVLink, mais ajouter un pont ne permet pas à toute application de traiter les deux cartes comme un seul GPU plus grand. Le logiciel doit répartir le travail et gérer les accès aux mémoires distinctes. Vérifiez la compatibilité du pont, l’écartement physique, le chemin de communication du logiciel et les éventuelles restrictions de virtualisation.
L’entraînement classique par parallélisme de données conserve une copie du modèle sur chaque GPU. Le tutoriel DistributedDataParallel de PyTorch distingue cette organisation du parallélisme de modèle. Pour répartir un modèle plus volumineux, utilisez une méthode prise en charge, comme le parallélisme tensoriel pour l’inférence, plutôt que d’additionner simplement les capacités de VRAM.
Comparez achat et location à partir de devis actuels
Ces GPU appartiennent à des générations anciennes. Les offres d’occasion, reconditionnées et hébergées varient selon la région, l’état, la garantie et la disponibilité. Un prix de lancement ou une annonce non datée ne constitue pas une recommandation d’achat actuelle. Demandez un devis pour la carte ou l’instance exacte et comparez aussi des solutions plus récentes avec les mêmes exigences.
Pour un achat, intégrez l’hôte compatible, l’alimentation, le refroidissement, l’électricité, les réparations et l’administration. Une carte passive bon marché peut se révéler peu intéressante si l’adaptation du système coûte plus que prévu. Pour une location, comptez le CPU, la RAM, le stockage, les transferts, la facturation des ressources inactives et la disponibilité du matériel demandé.
Si vous envisagez Compute with Hivenet, vérifiez le catalogue GPU et la configuration actuels. Ce comparatif n’établit pas que des instances A40 ou RTX 3090 y sont proposées. La documentation de facturation de Hivenet décrit un crédit prépayé au niveau de l’organisation et une facturation à la seconde pour les usages éligibles ; confirmez le tarif et le cycle de vie des ressources avant un essai.
Comment choisir ?
Retenez l’A40 parmi les candidats si l’application nécessite davantage de VRAM utilisable qu’un RTX 3090, ou si un déploiement validé a besoin de son ECC et de ses fonctions de virtualisation prises en charge. Vérifiez d’abord l’environnement serveur et les exigences logicielles.
Retenez le RTX 3090 si la charge tient avec une marge suffisante, si la carte exacte convient à votre système et si un devis actuel associé à une durée mesurée rend cette option économique. Pour les logiciels graphiques professionnels, vérifiez les combinaisons GPU-pilote prises en charge au lieu de supposer que chaque carte est certifiée pour tous les outils.
Si les deux solutions répondent aux exigences, exécutez le même travail représentatif sur chacune. Choisissez la configuration qui satisfait vos besoins de qualité, de latence et de reprise à un coût total justifiable.
Votre prochaine charge de travail sur Hivenet.
Choisissez une charge de travail d’IA, de calcul ou de stockage à tester sur Hivenet, ou échangez avec notre équipe sur sa mise en production.

