

Connectez-vous à Hivenet
Accédez à vos fichiers et gérez votre compte de stockage.
Store
Accédez à vos fichiers et gérez votre compte de stockage.
Compute
Lancez des instances et gérez vos ressources de calcul.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une connexion unifiée.
Vous avez juste besoin d'envoyer un fichier ?
Utilisez Send directementVous êtes nouveau sur Hivenet ? Commencez
Commencez avec Hivenet
Choisissez ce que vous voulez utiliser en premier.
Store
Sauvegardez des photos et des fichiers sur tous vos appareils.
Compute
Lancez le calcul GPU en libre-service pour les tâches exigeantes.
Store et Compute utilisent toujours des comptes distincts aujourd'hui. Nous travaillons sur une expérience de compte unifiée.
Vous avez besoin de Hivenet pour votre entreprise ?
Parlez au service des ventesVous avez besoin d'envoyer un fichier ?
Ouvrir SendVous avez déjà un compte ? Connectez-vous
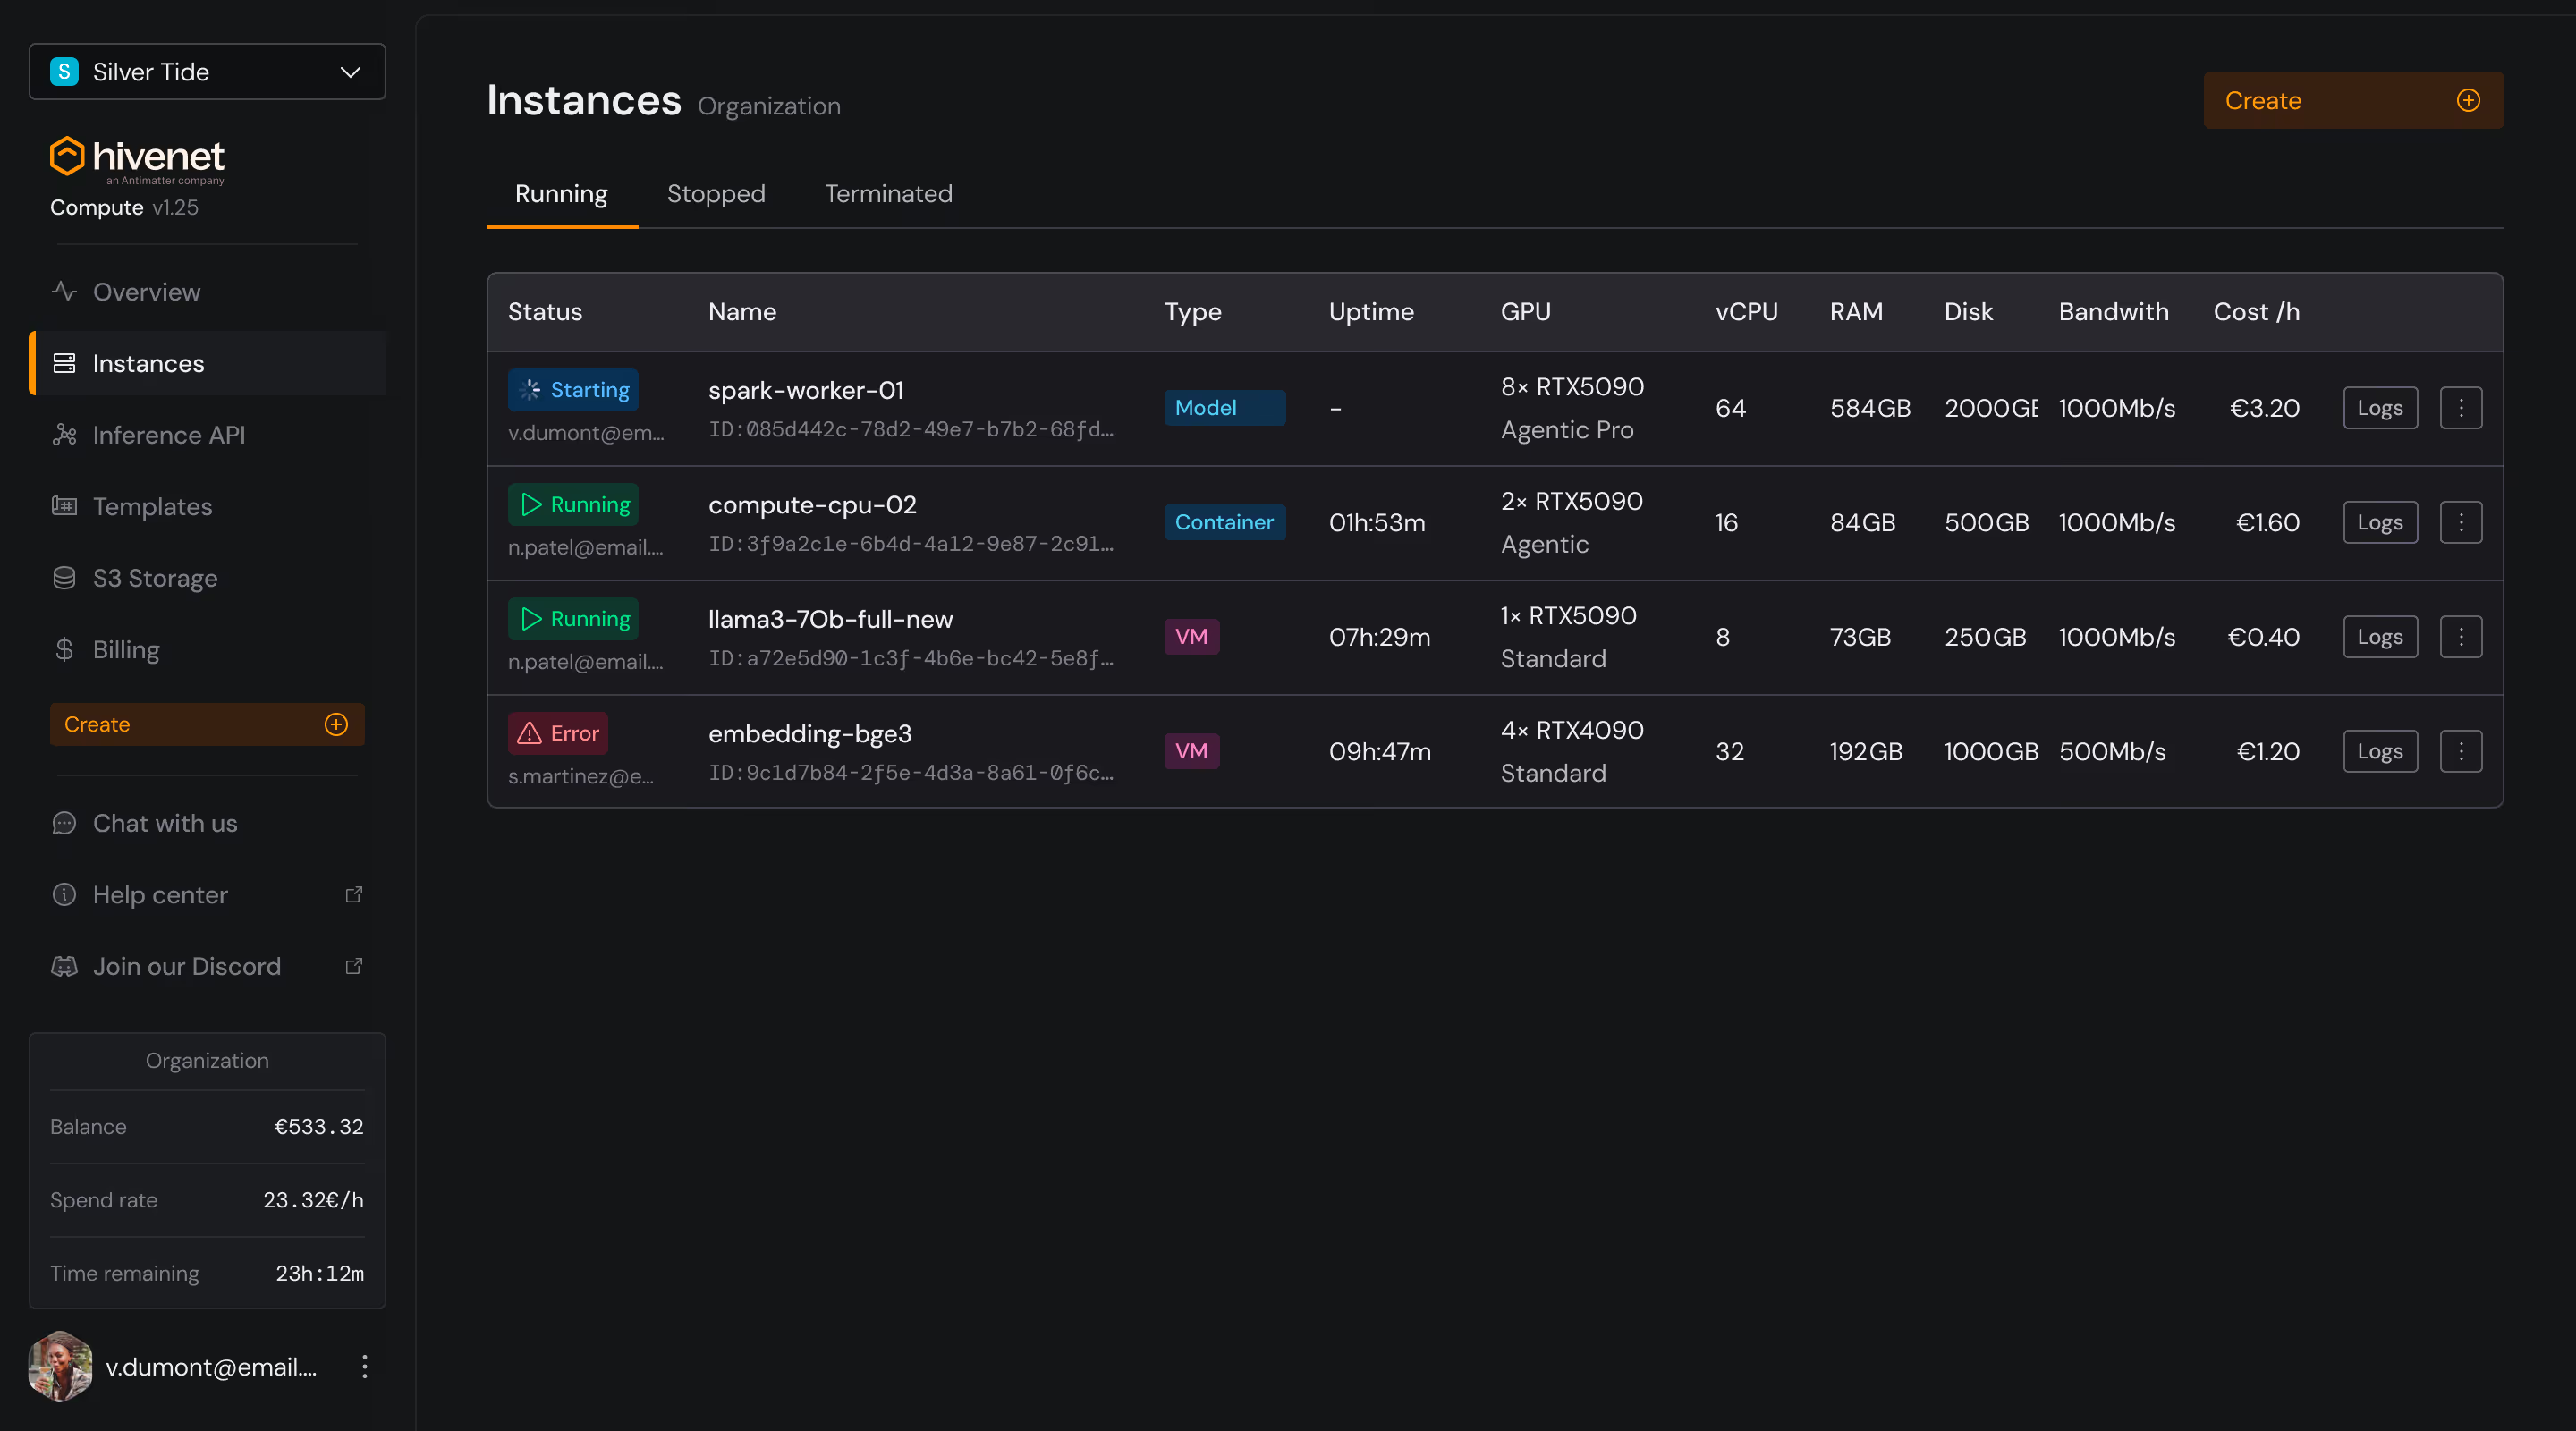
Calcul avec Hivenet
Affinez et entraînez des modèles d'IA avec GPU cloud hautes performances
Faites évoluer vos flux de travail d'IA grâce à des GPU abordables et performants. Ajustez Mistral, LLAMA et bien d'autres applications en quelques minutes grâce à notre système informatique basé sur le cloud. Accédez aux puissants Nvidia RTX 5090 pour une formation et une inférence fluides en matière d'IA.

Économisez jusqu'à 70 % par rapport aux principaux fournisseurs de cloud
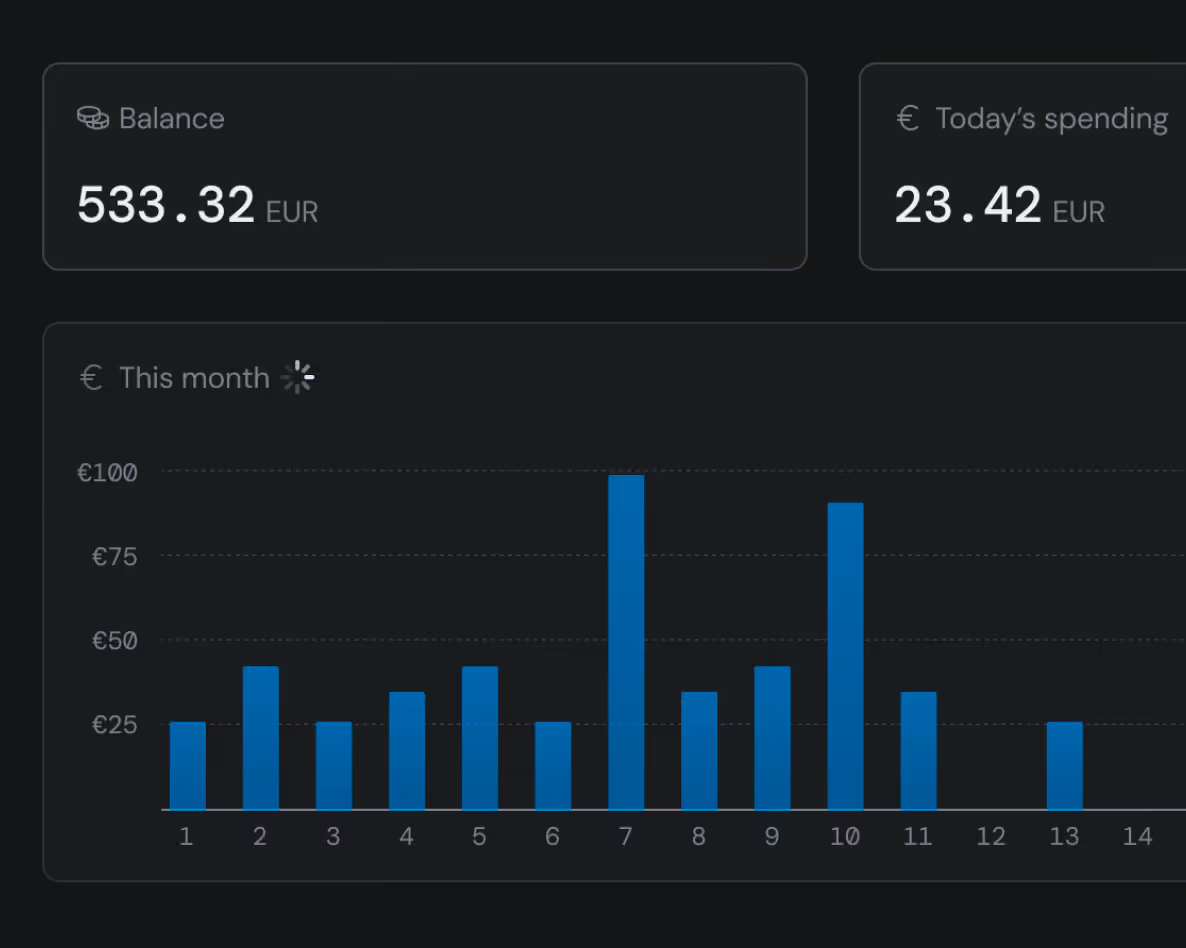
Payez uniquement pour ce que vous consommez, à la seconde près.
Pas de frais cachés, pas d'engagements à long terme.
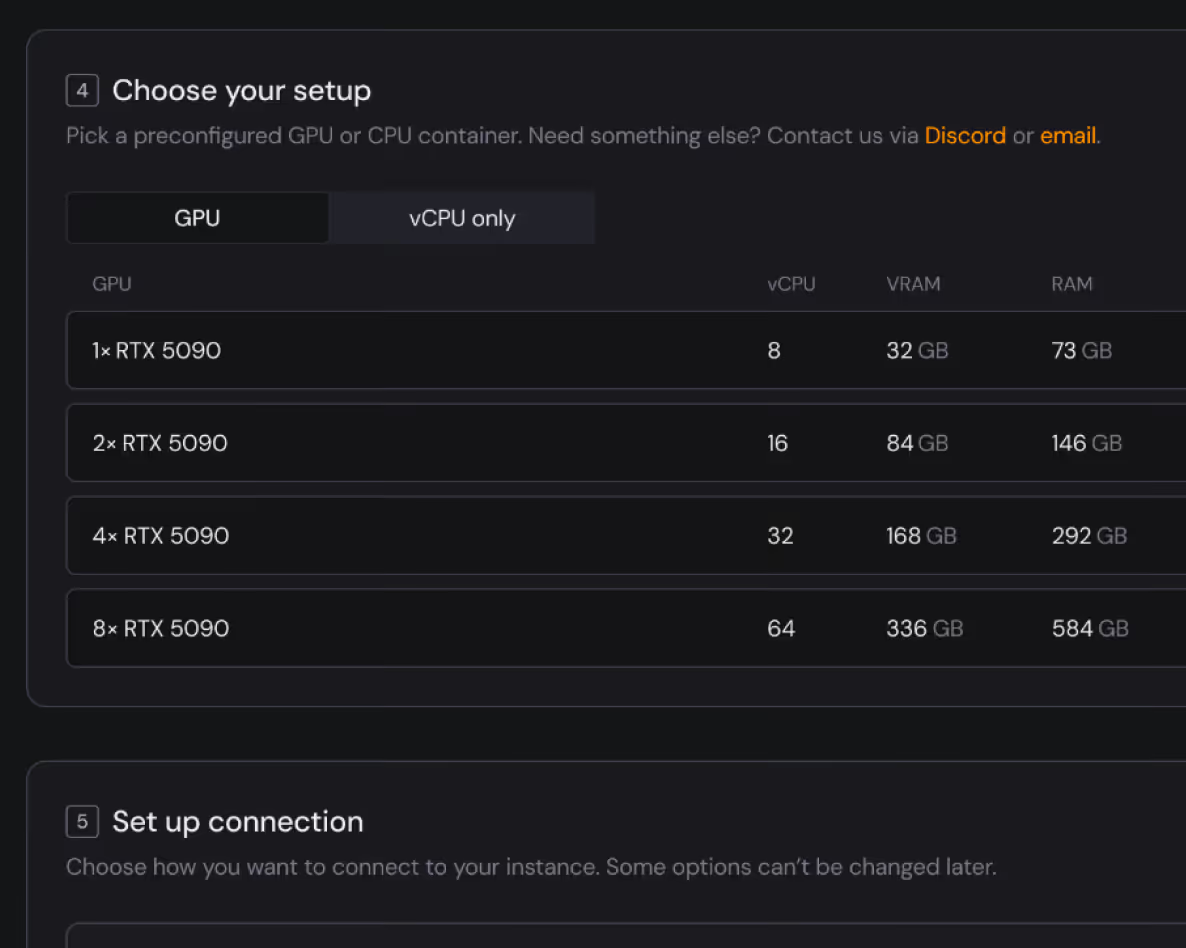
RTX 5090
1 ×
vCPU -
RAM - Go
Disk Space - Go
Bandwidth - Mb/s
€-/h
2 ×
vCPU -
RAM - Go
Disk Space - Go
Bandwidth - Mb/s
€-/h
4 ×
vCPU -
RAM - Go
Disk Space - Go
Bandwidth - Mb/s
€-/h
8 ×
vCPU -
RAM - Go
Disk Space - Go
Bandwidth - Mb/s
€-/h
Débit supérieur sur GPU unique, inférence sous 30B, charges de travail GPU exigeantes
Qui utilise Compute avec Hivenet
Les chercheurs, les startups, les studios et les équipes d'entreprises gèrent les charges de travail de production sur cette infrastructure. Ce n'est pas un bac à sable.
Compute a tout ce dont vous avez besoin besoins de charge de travail
Démarrez en quelques secondes
Commencez à entraîner votre modèle immédiatement après votre inscription

Préchargé avec les frameworks ML appropriés.
Accès root, connexion via SSH.
Configuration simple et rapide.
GPU abordables avec facturation à la seconde
Pas de frais cachés. Des prix simples et compétitifs
Aucuns frais d'entrée/sortie.
Aucuns frais supplémentaires pour la RAM, le processeur virtuel ou le stockage.
Inférence gérée avec vLLM
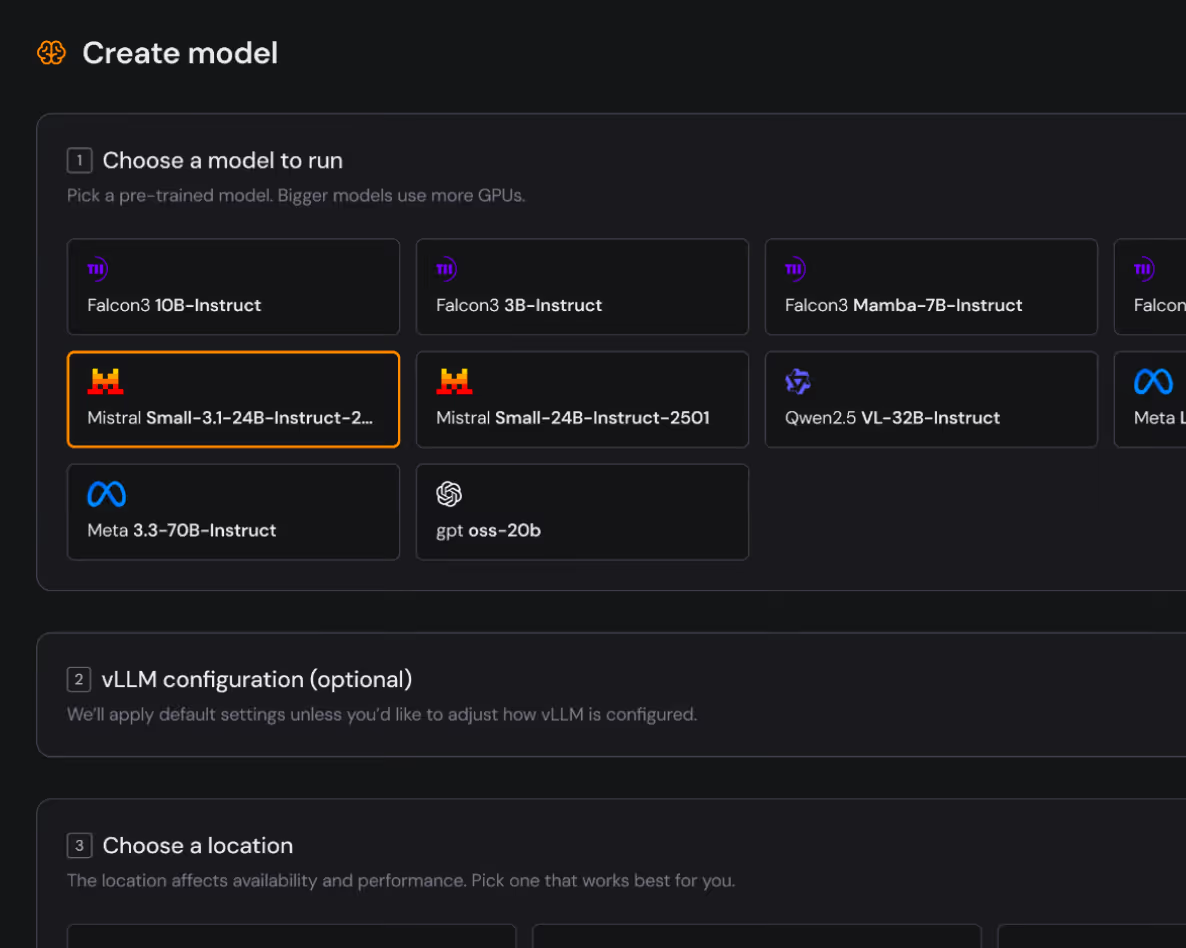
Lancez un serveur vLLM en quelques clics
Lancez un serveur vLLM en quelques clics. Définissez la fenêtre contextuelle et la simultanéité, diffusez des jetons et maintenez un débit élevé grâce à un traitement par lots continu
Courez charges de travail intensives en toute confiance
Choisissez la bonne configuration ML pour vos besoins de formation en IA
Best GPUs for AI inference.
Don’t miss this opportunity to scale your workflows with unmatched performance and savings.

